

Braki danych IoT to nie tylko puste pola w bazie. To symptom utraty pakietów, opóźnień transmisji albo awarii na konkretnej warstwie systemu. Pierwszy krok to zawsze identyfikacja warstwy, na której dane zniknęły, a nie zgadywanie przyczyny. Jeśli luka trwa krócej niż kilka cykli pomiarowych, warto rozważyć imputację. Jeśli trwa dłużej, oznacz ją jako brak i zbadaj przyczynę, zamiast ją maskować.
Krótko mówiąc:
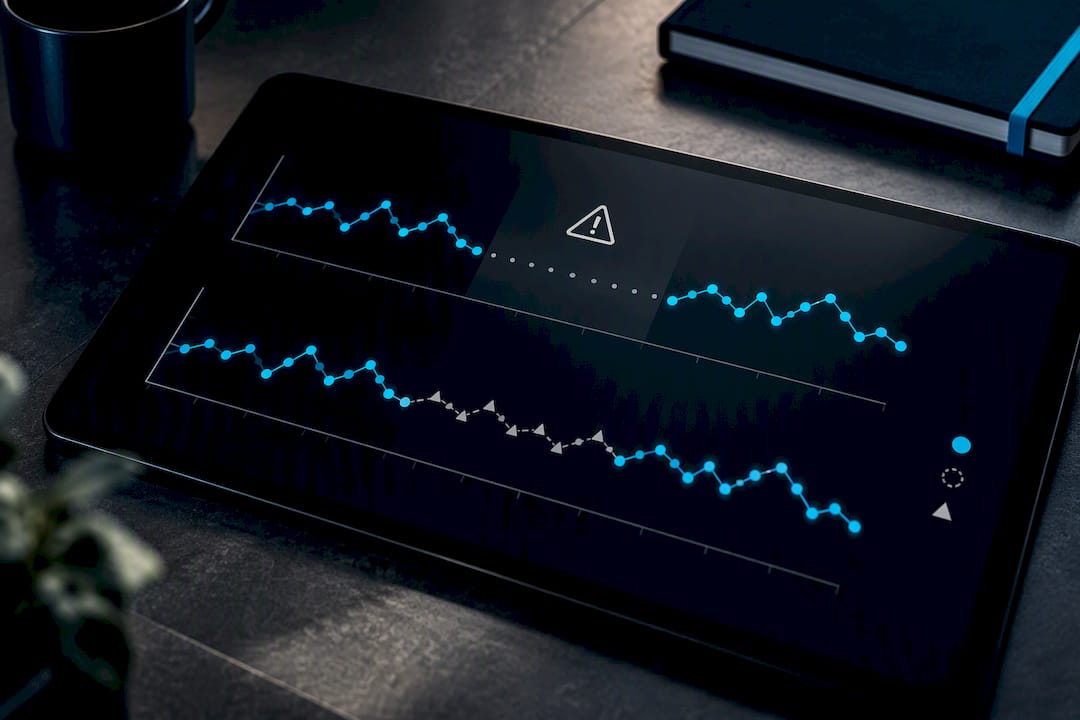
- W przypadku krótkich luk w danych warto rozważyć imputację, szczególnie jeśli przerwa jest dobrze znana i jest ograniczona czasowo.
- Diagnostyka braków danych powinna obejmować analizę wszystkich warstw systemu od urządzenia po magazyn danych, z naciskiem na liczniki restartów, metryki bramki i logi ingestu.
- Kluczowe jest monitorowanie długości najdłuższych przerw i czasu od ostatniej próbki, zamiast skupiać się jedynie na procentach braków, aby uniknąć fałszywych alarmów.
- Podczas analizy łącza radiowego nie należy opierać się wyłącznie na utracie pakietów; warto stosować testy black‑box i wskaźniki jakości takie jak SNR, by właściwie ocenić jego stabilność.
- Diagnostyka wymaga także przeprowadzania kontrolowanych awarii, które pozwalają zweryfikować działanie mechanizmów retry, store‑and‑forward i detekcji anomalii w praktyce.
Spis treści
- Formy braków danych IoT i jak je rozpoznać w telemetrii
- Mapa miejsc powstawania luk w typowym pipeline IoT
- Metryki i wskaźniki kompletności, które trzeba monitorować
- Procedura diagnostyczna krok po kroku po wykryciu braków
- Imputacja braków danych: metody, ryzyka i zasady zapisu metadanych
- Ocena linku i testy black‑box bez dostępu do warstwy fizycznej
- Jak Synaptix-platform wspiera wykrywanie i naprawę braków danych
- Wskazówki praktyka: najczęstsze błędy operacyjne
- Jak Synaptix-platform może pomóc z brakami danych IoT
- Źródła
- Najczęściej zadawane pytania
Formy braków danych IoT i jak je rozpoznać w telemetrii
Braki danych IoT rzadko wyglądają jak jedna, oczywista dziura w tabeli. Znacznie częściej to zestaw różnych symptomów, które trzeba umieć rozróżnić, bo każdy wskazuje na inną przyczynę i wymaga innej reakcji.
Cztery podstawowe formy braków wyglądają inaczej w logach:
- Missing (brak właściwy) — próbka nie dotarła w oczekiwanym czasie i nie ma po niej żadnego śladu w kolejce ani w buforze bramki.
- Stale (dana nieaktualna) — ostatnia odebrana wartość jest wielokrotnie powielana, bo urządzenie przestało wysyłać nowe odczyty, a system prezentuje stary stan jako aktualny.
- Odrzucone rekordy — pakiet dotarł, ale nie przeszedł walidacji schematu, checksumy albo autoryzacji i został usunięty na etapie ingestu.
- Opóźnienia (late arrivals) — dane docierają, ale poza oknem czasowym, które analityka uznaje za „na czas”, więc trafiają do złej partycji albo są odrzucane przez logikę deduplikacji.
W logach te cztery przypadki mają odrębne odciski. Prawdziwy brak objawia się jako dziura w sekwencji znaczników czasu, bez żadnego wpisu error. Dana nieaktualna to seria identycznych wartości przy nienaruszonej sekwencji timestampów. Odrzucone rekordy zostawiają wpis w logu ingestu, zwykle z kodem błędu schematu albo podpisu. Opóźnienia widać w różnicy między czasem zdarzenia a czasem przyjęcia przez system.
Typowy scenariusz diagnostyczny: dashboard pokazuje płaską linię temperatury przez trzy godziny. Sprawdzenie surowego strumienia telemetrycznego, a nie tylko device twin, pokazuje, że urządzenie faktycznie nie wysłało żadnej nowej próbki, nie że wartość się nie zmieniła. To rozróżnienie decyduje, czy szukasz problemu w sensorze, czy faktycznie mierzysz stabilny proces.
Mapa miejsc powstawania luk w typowym pipeline IoT
Braki danych IoT powstają na siedmiu możliwych warstwach, a każda zostawia inny rodzaj dowodu. Zamiast szukać po całym systemie, sprawdzaj po kolei, zaczynając od urządzenia i idąc w stronę magazynu danych.
- Sensor, zasilanie i firmware. Spadek napięcia baterii, przegrzanie albo błąd firmware powodują restart urządzenia. Ślad: liczniki restartów w logu urządzenia, skoki w numeracji sekwencji po każdym uruchomieniu.
- Bufor lokalny. Gdy pamięć urządzenia się przepełni przed nawiązaniem połączenia, najstarsze próbki są nadpisywane. Ślad: brakujące numery sekwencyjne bez odpowiadającego im wpisu retransmisji.
- Sieć radiowa i link. Zakłócenia, zanikanie sygnału czy zbyt duża odległość od bramki obniżają jakość transmisji. Ślad: spadający RSSI albo SNR skorelowany w czasie z rosnącą liczbą utraconych pakietów.
- Bramka lub warstwa edge. Przeciążenie procesora bramki, błąd sterownika protokołu albo awaria lokalnego bufora. Ślad: metryki CPU i pamięci bramki rosnące tuż przed utratą danych, wpisy w logu sterownika MQTT, OPC‑UA czy Modbus.
- Broker komunikacyjny. Utrata połączenia, przekroczenie limitu kolejki albo błąd autoryzacji tematu. Ślad: błędy schematu wiadomości, odrzucone publikacje, rozłączenia klienta w logu brokera.
- Pipeline ingestu. Walidacja odrzuca rekordy niezgodne ze schematem albo z powodu przekroczonego okna czasowego. Ślad: liczniki rekordów odrzuconych na wejściu, rosnące w konkretnych godzinach.
- Transformacja i magazyn danych. Błąd w zadaniu ETL, kolizja kluczy albo przekroczenie limitu zapisu w bazie. Ślad: różnica między liczbą rekordów na wejściu pipeline'u a liczbą zapisaną w docelowej tabeli.
Zbieranie dowodów wymaga trzech rodzajów danych: logów urządzenia (liczniki restartów, poziom baterii), metryk bramki (CPU, pamięć, kolejka) i audytu warstwy device twin, który pokazuje różnicę między ostatnim zgłoszonym stanem a pełną sekwencją zdarzeń. Case study integracji czujnika ze zleceniem serwisowym w pilotażu CMMS z IoT dobrze pokazuje, jak wygląda taka warstwowa inspekcja w praktyce.
Metryki i wskaźniki kompletności, które trzeba monitorować
Sama liczba brakujących próbek mówi mniej, niż się wydaje. Zespoły, które monitorują wyłącznie procent braków, przegapiają najważniejszy sygnał: rozkład tych braków w czasie i ich długość.
Podstawowy zestaw metryk kompletności obejmuje:
- Kompletność per urządzenie i tag — procent oczekiwanych próbek, które faktycznie dotarły, liczony osobno dla każdego czujnika, nie zbiorczo dla całej flotы.
- Liczba oczekiwanych vs odebranych próbek — punkt odniesienia oparty na deklarowanym interwale wysyłki urządzenia.
- Longest gap — długość najdłuższej nieprzerwanej przerwy w danych, kluczowa przy ocenie, czy dana kwalifikuje się do imputacji.
- Gap count — liczba odrębnych przerw w danym oknie czasowym, przydatna do wykrycia urządzeń z powtarzającą się niestabilnością.
- Age of last sample — czas od ostatniej odebranej próbki, najprostszy wskaźnik do alarmowania w czasie rzeczywistym.
Do tego dochodzą wskaźniki sieciowe: RSSI i SNR jako miara jakości sygnału radiowego, packet loss i liczniki retransmisji na poziomie protokołu, oraz poziom QoS w protokołach takich jak MQTT, który決uje, czy utracona wiadomość zostanie ponowiona.
Porada profesjonalisty: Nie ustawiaj progu alarmowego na sam procent braków. Dwa urządzenia z 5% braków mogą mieć zupełnie inny profil ryzyka — jedno traci po jednej próbce równomiernie, drugie ma jedną 40‑minutową przerwę. Alarmuj na longest gap i age of last sample, a procent traktuj jako wskaźnik pomocniczy.
Badanie porównujące metody odzyskiwania danych sensorowych wykazało, że technika oparta na korelacjach przestrzenno‑czasowych osiągnęła około 98,5% niezawodności na rzeczywistych danych testowych. To wysoki wynik, ale dotyczy konkretnych warunków testowych, nie każdej sieci sensorowej z automatu.
Konfigurując progi ostrzeżeń, ustaw je względem trybu pracy urządzenia, nie względem jednej stałej wartości. Czujnik w trybie uśpienia, który wysyła dane co godzinę, nie powinien uruchamiać tego samego alarmu co czujnik przemysłowy raportujący co pięć sekund. Brak tego rozróżnienia to najczęstsza przyczyna fałszywych alarmów w dużych wdrożeniach.
Procedura diagnostyczna krok po kroku po wykryciu braków
Gdy dashboard albo alarm sygnalizuje braki danych IoT, przypadkowe sprawdzanie kolejnych elementów systemu tylko wydłuża czas naprawy. Poniższa sekwencja pozwala zawęzić przyczynę w ciągu jednej sesji diagnostycznej.
- Ustal harmonogram i tolerancję. Sprawdź deklarowany interwał wysyłki urządzenia i dopuszczalne odchylenie. Bez tego punktu odniesienia nie odróżnisz normalnego jittera od realnego braku.
- Porównaj liczniki. Zestaw liczbę próbek oczekiwanych z liczbą odebranych na każdej warstwie: urządzenie, bramka, broker, magazyn. Miejsce, w którym liczby zaczynają się różnić, wskazuje warstwę winną.
- Skoreluj z restartami i zasilaniem. Nałóż czas wystąpienia braku na log restartów urządzenia i poziom baterii. Zbieżność w czasie silnie sugeruje przyczynę sprzętową.
- Przeanalizuj kolejki, retry i błędy schematu. Sprawdź logi brokera i pipeline'u ingestu w poszukiwaniu odrzuconych wiadomości, przekroczonych limitów kolejki albo niezgodności schematu.
- Wykonaj replay end‑to‑end z identyfikatorem korelacji. Wyślij testową próbkę z unikalnym identyfikatorem i śledź ją przez każdą warstwę, aż do magazynu danych. To pokazuje precyzyjnie, gdzie dana ginie albo się opóźnia.
- Podejmij decyzję o naprawie. Na podstawie zebranych dowodów zdecyduj, czy problem wymaga wymiany sprzętu, zmiany konfiguracji sieci, czy poprawki w logice ingestu.
Do tej procedury przydają się konkretne narzędzia: przechwytywanie pakietów na poziomie sieci, testy typu black‑box przy braku dostępu do warstwy fizycznej, inspekcja metryk bramki w czasie rzeczywistym oraz audyt device twin porównany z surowym strumieniem telemetrycznym. NIST IR 8349 zaleca dokumentowanie pełnego zakresu zachowań sieciowych urządzenia, czyli tworzenie profilu MUD, co znacząco ułatwia odróżnienie normalnego ruchu od anomalii już na etapie planowania wdrożenia.
Porada profesjonalisty: Zawsze testuj kontrolowaną awarię, zanim wystąpi realna. Odłącz zasilanie jednej bramki na pięć minut i sprawdź, czy mechanizm store‑and‑forward faktycznie odzyskuje kolejkę bez duplikatów. Jeśli nie masz odpowiedzi na to pytanie, nie masz też pewności, co się stanie podczas prawdziwej awarii.
Kontrolowane testy awarii — odłączenie zasilania, ograniczenie pamięci bramki, przerwanie łącza — pozwalają zweryfikować, jak faktycznie działają mechanizmy retry i deduplikacji zamiast opierać się na dokumentacji dostawcy.
Eskalacja do działań serwisowych ma sens wtedy, gdy diagnostyka wskazuje na przyczynę sprzętową, powtarzającą się na wielu urządzeniach tej samej partii, albo gdy longest gap przekracza próg krytyczny dla danego procesu produkcyjnego. Pojedyncza, izolowana przerwa na jednym czujniku rzadko wymaga wizyty technika w terenie.
Imputacja braków danych: metody, ryzyka i zasady zapisu metadanych
Imputacja nie jest uniwersalnym rozwiązaniem na braki danych IoT. To narzędzie do konkretnego przypadku: krótkiej, dobrze zrozumianej przerwy, nie substytut diagnostyki.
Cztery grupy metod dominują w praktyce:
- Interpolacja liniowa lub sezonowa — najszybsza i najprostsza, sprawdza się przy krótkich lukach w danych o przewidywalnym trendzie, jak temperatura czy wilgotność.
- Odzysk przestrzenny (spatial recovery) — wykorzystuje odczyty z sąsiednich czujników mierzących podobny parametr, przydatny w rozległych sieciach środowiskowych.
- Uzupełnianie macierzy (matrix completion) — traktuje dane wielu czujników jako macierz i uzupełnia brakujące wartości na podstawie ukrytych wzorców korelacji.
- Modele uczenia maszynowego takie jak BRITS, M‑RNN czy Message Propagation Imputation Network — stosowane przy strumieniach aperiodycznych i heterogenicznych, gdzie proste metody zawodzą.
Przegląd porównujący dwanaście metod imputacji na dużych zbiorach sensorów środowiskowych wykazał, że techniki wykorzystujące zależności przestrzenne dają lepsze wyniki niż podejścia oparte wyłącznie na trendzie czasowym. To sugeruje, że w sieciach z wieloma sensorami warto inwestować w metody korzystające z korelacji między urządzeniami, a nie tylko z historii jednego czujnika.
Każda imputowana wartość powinna nosić flagę jakości, nazwę metody, szacowaną niepewność i wersję algorytmu, który ją wygenerował. Bez tego zestawu metadanych dane syntetyczne stają się nierozróżnialne od rzeczywistych pomiarów, co jest jednym z częstszych powodów, dla których modele predykcyjne zaczynają zawodzić bez wyraźnej przyczyny.
Ta zasada wynika z pracy nad MPIN, która podkreśla, że ciągła imputacja w strumieniach czasowych wymaga jasnego rozróżnienia między danymi zaobserwowanymi i wygenerowanymi.
Długich przerw nie należy zastępować bez kontekstu. Rekomendacje oparte na analizie przyczyn braków wskazują, że niewłaściwa imputacja obniża jakość modeli i monitoringu w stopniu większym niż sam brak danych. Model predykcyjny trenowany na sfabrykowanych danych z długiej przerwy w zasilaniu czujnika wibracji może „nauczyć się”, że maszyna działa normalnie, podczas gdy w tym czasie mogła już wystąpić usterka niezarejestrowana przez żaden pomiar. Efekt: fałszywe poczucie bezpieczeństwa, które ujawnia się dopiero przy realnej awarii.
Ocena linku i testy black‑box bez dostępu do warstwy fizycznej
Liczenie utraconych pakietów jako jedynej miary jakości łącza jest zawodne. Ta metoda nie odróżnia utraty spowodowanej zakłóceniem radiowym od utraty wynikającej z przeciążenia bramki, a to dwie zupełnie różne przyczyny wymagające innej reakcji.
SNR bywa szybszym wskaźnikiem, ale ma swoje ograniczenia. Badania nad oceną łączy w warunkach 802.11 pokazują, że SNR jest przydatne głównie przy niskiej interferencji, a jego wartość diagnostyczna spada wraz z rosnącym poziomem zakłóceń otoczenia.
Gdy nie masz dostępu do warstwy fizycznej sieci, sprawdza się test typu black‑box. Metoda opisana przez NIST polega na wstrzyknięciu znanego wzorca sygnału i korelacji wyjścia z wejściem, co pozwala oszacować opóźnienie transmisji i błąd sygnału bez znajomości parametrów warstwy radiowej.
| Metoda oceny linku | Co mierzy | Kiedy stosować |
|---|---|---|
| Zliczanie utraconych pakietów | Procent nieodebranych pakietów | Wstępny, orientacyjny wskaźnik, wymaga potwierdzenia inną metodą |
| SNR | Jakość sygnału względem szumu | Środowiska o niskiej interferencji, szybka diagnostyka |
| Test black‑box (wstrzyknięcie wzorca) | Opóźnienie i błąd RMS sygnału | Brak dostępu do warstwy fizycznej, sieci przemysłowe |
| ETX (expected transmission count) | Szacowana liczba transmisji potrzebna do dostarczenia pakietu | Ocena stabilności trasy w sieciach mesh |
Interpretacja wyników testu black‑box polega na porównaniu zmierzonego opóźnienia i błędu RMS z wartościami referencyjnymi dla danej topologii sieci. Gdy błąd RMS systematycznie rośnie przy stałym poziomie ruchu, to sygnał do zmiany kanału radiowego, przesunięcia bramki albo zmiany topologii mesh na gwiazdę, zamiast do dalszego dostosowywania parametrów oprogramowania.
Jak Synaptix-platform wspiera wykrywanie i naprawę braków danych
Diagnostyka opisana w poprzednich sekcjach wymaga narzędzi, które łączą metryki kompletności z kontekstem operacyjnym maszyny. Moduł GridSense monitoruje aktywa w czasie rzeczywistym i nakłada metryki takie jak heartbeat urządzenia, longest gap oraz age of last sample na jeden dashboard, zamiast rozpraszać je między systemem SCADA, bramką i arkuszem kalkulacyjnym.
Drugi moduł, AutomateFlow, automatyzuje przetwarzanie dokumentów serwisowych (OCR, NP, routing systemów klasy CMMS czy ERP), co ma znaczenie wtedy, gdy diagnostyka braków danych prowadzi do zlecenia serwisowego. Zamiast ręcznie przepisywać wynik diagnostyki do systemu, zdarzenie trafia automatycznie do odpowiedniego przepływu pracy. Podobny mechanizm ekstrakcji danych z dokumentów, bez ręcznego przepisywania, opisuje też SzopaLabs w swoim przewodniku o wyciąganiu danych z faktur, co dobrze ilustruje ogólny kierunek automatyzacji dokumentów w operacjach przemysłowych.
Typowy pilot zaczyna się od audytu źródeł danych: które czujniki, bramki i protokoły faktycznie zasilają analitykę. Następnie wdraża się mechanizm heartbeat i dashboard kompletności per urządzenie, a na końcu ustala się procedury eskalacji, czyli kto i w jakim czasie reaguje na przekroczenie longest gap lub spadek RSSI poniżej ustalonego progu.
Więcej o synchronizacji znaczników czasu, która jest fundamentem każdej takiej diagnostyki, znajdziesz w materiale o synchronizacji czasu OT.
Wskazówki praktyka: najczęstsze błędy operacyjne
Największy błąd, jaki widzę w zespołach zarządzających danymi IoT, to mierzenie tylko procentu braków. Ten wskaźnik nic nie mówi o tym, czy stoisz przed dziesięciu krótkimi przerwami czy jedną godzinną ciszą radiową na krytycznej maszynie. Mierz długość luk, nie tylko ich odsetek.
Drugi błąd to wiara, że mechanizmy retry i store‑and‑forward działają, bo tak napisano w specyfikacji dostawcy. Przetestuj to sam, przez kontrolowaną awarię zasilania albo łącza. Trzeci, może najkosztowniejszy błąd to nadpisywanie braków imputacją bez zapisania metadanych. Kiedy za pół roku model predykcyjny zacznie się zachowywać nietypowo, nikt nie będzie w stanie odróżnić, które dane były realne, a które wygenerowane.
Prowadź dokumentację cyklu życia urządzeń i korzystaj z zasad MUD przy każdym nowym wdrożeniu. Gdy bramka nagle się restartuje albo packet loss skacze bez ostrzeżenia, masz punkt odniesienia, żeby ocenić, czy to anomalia, czy nowy normalny wzorzec pracy.
— Mateusz
Jak Synaptix-platform może pomóc z brakami danych IoT
Proponowane są trzy ścieżki wdrożenia zamiast jednego uniwersalnego pakietu: Pilot, Platform i Enterprise, dobierane do skali integracji i liczby modułów, które faktycznie potrzebujesz.
Pilot skupia się na jednym problemie naraz, na przykład na audycie kompletności danych z konkretnej linii produkcyjnej i wdrożeniu odpowiedniego dashboardu heartbeat. Wynik pilota da Ci konkretne liczby: kompletność per urządzenie przed i po wdrożeniu, longest gap na krytycznych czujnikach oraz czas reakcji na alarm. Platforma rozszerza to na całą flotę aktywów i integruje przepływ zdarzeń z systemem CMMS lub ERP, a na poziomie Enterprise można wyszukać wdrożenia z bardziej zaawansowaną integracją oraz architekturę dostosowaną do konkretnych urządzeń.
Zamiast zgadywać, który plan odpowiada Twojej skali, sprawdź aktualny zakres i szczegóły ofertowe na stronie z cenami Synaptix i zapytaj o pilota dopasowany do Twojej instalacji.
Źródła
Poniższe materiały stanowią podstawę techniczną tego przewodnika i warto po nie sięgnąć, jeśli wdrażasz własną procedurę diagnostyczną:
Najczęściej zadawane pytania
Co to jest IoT?
IoT (internet rzeczy) to sieć fizycznych urządzeń wyposażonych w czujniki i łączność, które zbierają i przesyłają dane bez ciągłej interwencji człowieka. W kontekście przemysłowym obejmuje to czujniki maszyn, bramki edge i systemy monitorowania aktywów w czasie rzeczywistym.
Jakie są przykłady IoT w przemyśle?
Typowe przykłady to czujniki wibracji i temperatury na maszynach produkcyjnych, liczniki energii z funkcją wykrywania anomalii oraz urządzenia DWA obsługujące zlecenia techników w terenie. Moduł GridSense w Synaptix-platform korzysta właśnie z tego rodzaju strumieni danych do ciągłego monitorowania zdrowia maszyn.
Co to jest technologia IoT z perspektywy zarządzania danymi?
Z perspektywy analityka danych, technologia IoT to nie tylko czujniki, ale cały pipeline: sensor, bramka, sieć, broker komunikacyjny, warstwa ingestu i magazyn danych. Każda z tych warstw może być źródłem braków danych IoT i wymaga własnego zestawu metryk diagnostycznych.
Dlaczego mam braki w transmisji danych z czujnika?
Najczęstsze przyczyny to niestabilne zasilanie powodujące restarty urządzenia, słaby sygnał radiowy mierzony przez RSSI lub SNR, przeciążenie bramki albo błędy walidacji schematu na etapie ingestu. Diagnostykę zawsze zaczynaj od porównania liczby oczekiwanych i odebranych próbek na każdej warstwie, żeby zawęzić przyczynę zamiast sprawdzać wszystko naraz.
Kiedy warto uzupełniać braki danych metodą imputacji?
Imputacja ma sens przy krótkich, dobrze zrozumianych przerwach, gdzie metody takie jak interpolacja czy odzysk przestrzenny dają wiarygodny wynik. Długie przerwy lub te wynikające z awarii sensora powinny być oznaczone jako brak, a nie zastępowane bez kontekstu, bo niewłaściwa imputacja obniża jakość modeli predykcyjnych.