
Kluczowe KPI utrzymania ruchu to: MTBF, MTTR, OEE oraz metryki planowania, czyli PMP i schedule compliance. Zacznij od nich, dopilnuj równowagi między wskaźnikami wyprzedzającymi i opóźnionymi, i nie licz ich ręcznie w arkuszach, jeśli chcesz mieć wiarygodne dane. Bez systemu CMMS lub warstwy predictive maintenance te liczby szybko się rozjeżdżają z rzeczywistością na hali.
Krótko mówiąc:
- Kluczowe KPI utrzymania ruchu to MTBF, MTTR, OEE oraz metryki planowania, które powinny być monitorowane w systemach automatycznych, aby unikać błędów pomiarowych.
- Wskaźniki opóźnione, takie jak liczba awarii czy koszt utrzymania, muszą być uzupełnione o wskaźniki wyprzedzające, które ostrzegają przed przyszłymi problemami i są raportowane częściej.
- Przy planowaniu KPI istotne jest stosowanie porównań do branżowych benchmarków i regularna korekta celów, aby wskaźniki odzwierciedlały realny stan i cele zakładu.
- Ręczne zbieranie danych skutecznie zastępuje automatyzacja przez systemy CMMS i predictive maintenance, które pozwalają na prognozowanie awarii i optymalizację działań.
- Wdrożenie narzędzi AI umożliwia analizę trendów i automatyzację dokumentacji, co poprawia skuteczność monitorowania KPI i wspiera decyzje proaktywne.
Spis treści
- Definicje i wzory: MTBF, MTTR, MTTF, OEE — jak liczyć bez błędów
- Leading vs lagging: które KPI ostrzegają, a które tylko raportują
- Metryki planowania i wykonania prac: PMP, schedule compliance, backlog i koszty
- Interpretacja KPI w praktyce: scenariusze, Pareto i FMEA
- Narzędzia do monitorowania KPI: CMMS, predictive maintenance i wdrożenie krok po kroku
- Zastosowania AI w pomiarze i poprawie KPI
- Jak interpretować KPI razem, żeby nie zgubić obrazu całości
- Benchmarki i cele: jak ustawiać wartości odniesienia i korygować je w czasie
- Przykłady praktyczne wdrożenia KPI w utrzymaniu ruchu
- Najczęstsze wyzwania i błędy przy stosowaniu KPI
- Zalety i ograniczenia poszczególnych KPI w utrzymaniu ruchu
- Jak KPI wpływają na decyzje zarządcze i optymalizację procesów
- Perspektywa autora: priorytety i pułapki przy wdrażaniu KPI
- Pilotaż Synaptix jako praktyczny start do lepszych KPI
- Źródła
- Najczęściej zadawane pytania
Definicje i wzory: MTBF, MTTR, MTTF, OEE — jak liczyć bez błędów
MTBF (średni czas między awariami) liczysz jako całkowity czas pracy maszyny podzielony przez liczbę awarii w danym okresie. MTBF jest liczone jako całkowity czas pracy maszyny podzielony przez liczbę awarii w danym okresie, co odzwierciedla średni czas między awariami. MTTR (średni czas naprawy) to suma czasu przestojów naprawczych podzielona przez liczbę tych napraw — 4 awarie po 2 godziny dają MTTR równe 2 godziny. MTTF (średni czas do awarii) stosuje się głównie dla elementów nienaprawialnych i liczy się go jako sumę czasu działania do pierwszej awarii podzieloną przez liczbę badanych jednostek.

OEE (całkowita efektywność wyposażenia) to iloczyn trzech składowych: dostępności, wydajności i jakości. Dostępność to czas pracy rzeczywisty podzielony przez czas planowany. Wydajność porównuje realną prędkość produkcji z prędkością nominalną. Jakość to udział dobrych sztuk w całości produkcji. Zakład z dostępnością 90%, wydajnością 95% i jakością 98% ma OEE równy iloczynowi dostępności, wydajności i jakości, poprawny poziom wyliczany jest na podstawie wszystkich trzech składowych.
Największe źródła błędów pomiarowych, na które warto zwrócić uwagę:
- Niekonsekwentne definiowanie „przestoju“ — część zespołów wlicza przezbrojenia, część nie.
- Ręczne wpisywanie czasu awarii przez operatorów z dużym opóźnieniem lub zaokrągleniem do pełnych godzin.
- Mieszanie danych z różnych zmian bez jednolitego kalendarza produkcyjnego.
- Brak rozróżnienia między przestojem planowanym i nieplanowanym w raportach OEE.
Reliability and Maintainability Center podkreśla, że wybór KPI musi wynikać z celów operacyjnych zakładu, nie z tego, co łatwo policzyć w arkuszu.
Leading vs lagging: które KPI ostrzegają, a które tylko raportują
Wskaźniki opóźnione (lagging) mówią, co się już stało: MTBF, liczba awarii w miesiącu, koszt utrzymania na jednostkę produkcji. Wskaźniki wyprzedzające (leading) mówią, co się zaraz stanie: procent zleceń zapobiegawczych wykonanych na czas, trend wibracji na łożysku, liczba zaplanowanych inspekcji zrealizowanych w terminie.
Zbalansowany zestaw KPI trzyma się trzech zasad:
- Każdy lagging KPI powinien mieć odpowiadający mu leading KPI (np. MTBF i procent realizacji przeglądów zapobiegawczych).
- Leading KPI raportuj częściej — tygodniowo lub nawet dziennie, bo ich sens polega na szybkiej reakcji.
- Prezentuj oba typy na osobnych wykresach trendów, nigdy w jednej zbiorczej tabeli, bo mieszanie horyzontów czasowych maskuje sygnały ostrzegawcze.
PNNL wskazuje, że połączenie obu grup KPI umożliwia zarządzanie proaktywne, a nie tylko rejestrowanie strat po fakcie.
Porada profesjonalisty: Jeśli Twój dashboard ma więcej wskaźników lagging niż leading, to znak, że dział utrzymania ruchu wciąż gasi pożary, a nie zapobiega im.
Metryki planowania i wykonania prac: PMP, schedule compliance, backlog i koszty
Procent pracy planowanej (PMP) mierzy udział zaplanowanych zadań, a jego cel referencyjny różni się w zależności od branży, zwykle mieszcząc się w wyższym przedziale wartości. Schedule compliance mierzy procent zadań zrealizowanych w terminie, a dobry wynik jest powyżej wysokiego poziomu ustalanego indywidualnie dla danego zakładu.
Backlog, czyli zaległość prac, pokazuje sumę godzin roboczych czekających na realizację. Rosnący backlog przy stabilnej liczbie techników zwykle zwiastuje przyszły wzrost awarii, bo prace zapobiegawcze się odkładają. Rework, czyli powtórne naprawy tej samej usterki w krótkim czasie, to twardy sygnał słabej jakości diagnozy albo braku odpowiednich części.
Praktyczne mapowanie tych wskaźników:
- PMP poniżej 60% oznacza dział działający głównie reaktywnie, mimo dobrych intencji planowania.
- Backlog powyżej 4 tygodni roboczych sygnalizuje niedobór zasobów lub błędną priorytetyzację zleceń.
- Wysoki rework (powyżej kilku procent zleceń) wskazuje na problem z diagnostyką, nie z samą naprawą.
- Koszt utrzymania w relacji do wartości zastępczej aktywów (Maintenance cost / RAV) pozwala porównywać wydatki między liniami czy zakładami niezależnie od ich wielkości.
SMRP publikuje ustandaryzowane definicje tych metryk wraz z benchmarkami, co ułatwia porównania między zakładami tej samej firmy.
Interpretacja KPI w praktyce: scenariusze, Pareto i FMEA
Pojedynczy wskaźnik nigdy nie mówi całej prawdy. Wysoka dostępność przy niskiej jakości oznacza, że maszyna pracuje, ale produkuje odpady. Niski MTTR przy rosnącym backlogu może znaczyć, że technicy szybko gasią pożary, zamiast wykonywać plan.
Cztery typowe scenariusze i reakcje, które się w nich sprawdzają:
- OEE spada, MTBF stabilny — sprawdź składową jakości i wydajności, problem leży poza samą niezawodnością mechaniczną.
- MTTR rośnie, PMP wysoki — dobre planowanie nie przekłada się na sprawne naprawy, zwykle to problem z dostępnością części zamiennych.
- Backlog rośnie, schedule compliance spada — zespół nie ma zasobów na realizację planu, konieczna rewizja priorytetów lub zwiększenie obsady.
- MTBF spada tylko na jednej maszynie w linii — analiza Pareto zwykle pokazuje, że 20% aktywów generuje 80% przestojów, więc tam trzeba skierować FMEA (analizę przyczyn i skutków awarii).
Poziom agregacji ma znaczenie: KPI liczone dla całego zakładu maskują problemy pojedynczych maszyn, a KPI liczone tylko dla maszyny gubią kontekst linii produkcyjnej. Badania nad wdrożeniami TPM (total productive maintenance) pokazują wymierne wzrosty OEE i skrócenie czasu naprawy po wprowadzeniu konserwacji autonomicznej połączonej z analizą przyczyn awarii na poziomie poszczególnych maszyn, nie tylko linii.
Narzędzia do monitorowania KPI: CMMS, predictive maintenance i wdrożenie krok po kroku
Ręczne liczenie KPI w arkuszach kalkulacyjnych kończy się tym samym problemem: dane spływają z opóźnieniem, zależą od tego, kto akurat wypełniał raport, i praktycznie nigdy nie nadają się do prognozowania. System CMMS automatyzuje rejestrowanie czasu przestojów, zleceń i kosztów, co eliminuje większość błędów opisanych wyżej przy MTBF i MTTR.
Predictive maintenance i czujniki IoT przesuwają KPI z rejestrowania w stronę przewidywania. Zamiast czekać na awarię, żeby policzyć MTBF, monitorujesz trend wibracji, temperatury czy prądu silnika i reagujesz zanim licznik przestojów ruszy. RMC opisuje to jako przejście od raportowania „co się stało wczoraj“ do sterowania procesem w czasie rzeczywistym.
Rozsądny plan wdrożenia wygląda tak:
- Zacznij od pilota na jednej krytycznej linii lub grupie maszyn, nie od razu na całym zakładzie.
- Zintegruj czujniki i CMMS z ERP, żeby dane o kosztach i częściach zamiennych łączyły się z danymi o niezawodności.
- Ustal metryki sukcesu pilota przed startem — np. redukcja MTTR o określony procent w ciągu kwartału.
- Skaluj tylko te elementy pilota, które faktycznie poprawiły wskaźniki, resztę koryguj albo odrzuć.
Porada profesjonalisty: Pilot bez wcześniej zdefiniowanej metryki sukcesu to nie pilot, to eksperyment bez kontroli — trudno go później uzasadnić przed zarządem.
Zastosowania AI w pomiarze i poprawie KPI
W niektórych rozwiązaniach dostępne są funkcje łączenia danych maszynowych, modeli predykcyjnych i automatyzacji dokumentów w jednym środowisku, które mogą wpływać na jakość KPI utrzymania ruchu. Moduły monitorujące stan aktywów w czasie rzeczywistym mogą zasilać wskaźniki takie jak MTBF czy trend wibracji danymi bez ręcznego wprowadzania. Inne moduły automatyzują przetwarzanie dokumentów serwisowych, co może skracać czas między zamknięciem zlecenia a aktualizacją wskaźników PMP i schedule compliance.
Wdrożenie technologii przewidywania awarii może znacząco zredukować nieplanowane przestoje, choć efekt zależy od stanu infrastruktury i jakości danych wejściowych.
Ta liczba pochodzi z deklaracji własnych platformy, nie z niezależnego badania, więc traktuj ją jako punkt odniesienia do własnej weryfikacji, nie jako gwarancję. Warto uzupełnić ją o dane referencyjne z konkretnych wdrożeń sektorowych oraz o studia przypadków z zakładów o podobnej skali produkcji.
Jak interpretować KPI razem, żeby nie zgubić obrazu całości
Żaden pojedynczy wskaźnik nie zastąpi zestawu. Zakład, który śledzi tylko OEE, może przeoczyć, że backlog rośnie od trzech miesięcy, bo OEE krótkoterminowo wciąż wygląda dobrze dzięki nadgodzinom techników. Zakład, który śledzi tylko MTTR, może nie zauważyć, że MTBF spada, bo naprawy są coraz szybsze, ale coraz częstsze.
Dobra praktyka to budowanie KPI w warstwach. Na poziomie maszyny śledzisz MTTR i trend kondycji technicznej. Na poziomie linii patrzysz na OEE i backlog. Na poziomie zakładu liczysz koszt utrzymania względem wartości aktywów i ogólny trend MTBF. Każda warstwa odpowiada innej decyzji: technik reaguje na poziomie maszyny, kierownik linii planuje zasoby, dyrektor zakładu decyduje o budżecie inwestycyjnym.

Sprzeczne sygnały między warstwami nie są błędem pomiaru, tylko informacją. Jeśli MTBF na poziomie zakładu rośnie, a backlog na poziomie linii też rośnie, to znaczy, że dział radzi sobie z niezawodnością, ale traci zdolność do planowania z wyprzedzeniem. Traktowanie KPI jako zestawu połączonych naczyń, a nie osobnych liczb, jest jedynym sposobem, żeby uniknąć decyzji podjętych na podstawie fragmentu obrazu.
Benchmarki i cele: jak ustawiać wartości odniesienia i korygować je w czasie
Cele KPI nie powinny być kopiowane wprost z branżowych tabel bez uwzględnienia specyfiki zakładu. SMRP publikuje ponad 70 standaryzowanych metryk z proponowanymi wartościami odniesienia, ale to punkt startowy do adaptacji, nie sztywna norma do wdrożenia bez zmian.
Praktyczny sposób ustawiania celów wygląda tak: zmierz obecny poziom każdego kluczowego KPI przez co najmniej jeden pełny cykl produkcyjny, porównaj go z benchmarkiem branżowym, a potem ustal cel pośredni na kolejny kwartał, nie cel docelowy na już.
Cele wymagają regularnej korekty. RMC opisuje KPI jako proces dynamiczny: po każdym wdrożeniu zmiany operacyjnej trzeba sprawdzić, czy wskaźnik faktycznie reaguje w oczekiwanym kierunku, a jeśli nie, zrewidować albo sam cel, albo metodę pomiaru. Kwartalny przegląd celów w zestawieniu z rzeczywistymi wynikami powinien być stałym punktem w kalendarzu działu utrzymania ruchu, nie czynnością wykonywaną tylko przy audytach.
Przykłady praktyczne wdrożenia KPI w utrzymaniu ruchu
Okazało się, że dostępność była w normie, ale jakość spadała przez mikroprzestoje niewidoczne w standardowym raporcie zmianowym. Wprowadzenie liczników mikroprzestojów i codziennego przeglądu tego KPI podniosło jakość o kilka punktów procentowych w ciągu dwóch miesięcy.
Inny typowy przypadek to zakład z wysokim MTBF, ale rosnącym kosztem utrzymania na jednostkę produkcji. Analiza backlogu pokazała, że technicy realizowali dużo drobnych, niekrytycznych zleceń, zaniedbując przeglądy zapobiegawcze na maszynach o największym wpływie na produkcję. Przesunięcie priorytetów w harmonogramie prac, oparte na analizie Pareto, obniżyło koszt na jednostkę bez pogorszenia MTBF.
Wspólny wzorzec w obu przypadkach: problem nie był widoczny w jednym wskaźniku, tylko w relacji między kilkoma z nich. Zakłady, które traktują KPI jako narzędzie diagnostyczne, a nie tylko raport do zarządu, szybciej znajdują właściwy punkt interwencji.
Najczęstsze wyzwania i błędy przy stosowaniu KPI
Najczęstszy błąd to wybieranie KPI, bo są łatwe do policzenia, nie bo są istotne dla celów zakładu. Drugi typowy problem to porównywanie wskaźników między zakładami bez jednolitej definicji przestoju czy awarii, co prowadzi do wniosków nieporównywalnych między sobą.
Trzeci błąd, bardzo częsty w praktyce, to nagradzanie techników za wskaźniki, które łatwo manipulować. Jeśli premia zależy od schedule compliance, a definicja „zrealizowanego zadania“ jest nieprecyzyjna, zespół zacznie zamykać zlecenia formalnie, bez faktycznego wykonania pracy. Czwarty problem to zbyt duża liczba KPI na jednym dashboardzie. Zestaw z dwudziestoma wskaźnikami rozprasza uwagę kierowników, którzy w efekcie nie skupiają się na żadnym.
Piąty, często niedoceniany błąd, to brak standaryzacji zbierania danych. Standard ISO 14224 dostarcza ram do jednolitego rejestrowania danych o niezawodności, co ma znaczenie zwłaszcza przy porównaniach między zakładami tej samej organizacji. Bez takiej standaryzacji nawet dobrze zdefiniowane KPI dają wyniki, których nie da się zestawić.
Zalety i ograniczenia poszczególnych KPI w utrzymaniu ruchu
MTBF dobrze pokazuje ogólny trend niezawodności, ale słabo radzi sobie z maszynami o niskiej liczbie awarii, gdzie jedna nietypowa usterka zniekształca cały wskaźnik na miesiące. MTTR jest łatwy do zebrania i szybko reaguje na zmiany w organizacji pracy, ale nie mówi nic o częstotliwości awarii, więc sam w sobie nie ocenia niezawodności.
OEE daje kompleksowy obraz efektywności, jednak jego siła jest też słabością: spadek w jednej składowej łatwo maskuje wzrost w innej, więc zarząd widzi stabilny wynik, mimo że problem narasta. PMP i schedule compliance dobrze mierzą dyscyplinę planowania, ale nie odróżniają dobrze zaplanowanej pracy od pracy zaplanowanej pod presją wskaźnika, czyli sztucznie.
Backlog jest cennym wskaźnikiem wczesnego ostrzegania, ale wymaga kontekstu liczby dostępnych techników, bo sam wzrost godzin roboczych w kolejce nie znaczy nic bez odniesienia do zasobów. Koszt utrzymania względem wartości aktywów dobrze porównuje zakłady różnej wielkości, jednak reaguje z dużym opóźnieniem na zmiany operacyjne, więc nie nadaje się do codziennego zarządzania.
Jak KPI wpływają na decyzje zarządcze i optymalizację procesów
KPI utrzymania ruchu przekładają się na konkretne decyzje budżetowe i organizacyjne, nie tylko na raporty. Rosnący koszt utrzymania względem wartości aktywów, w połączeniu ze spadającym MTBF, jest zwykle silniejszym argumentem za wymianą maszyny niż sama jej wiek czy subiektywna ocena stanu technicznego.
Wysoki i stabilny PMP przy niskim schedule compliance zwykle prowadzi do decyzji o zwiększeniu obsady technicznej, nie o zmianie systemu planowania, bo problem leży w zasobach, nie w procesie. Z kolei niski PMP przy dobrym schedule compliance sugeruje odwrotnie: zespół dobrze realizuje to, co zaplanuje, ale planuje za mało z wyprzedzeniem, więc inwestycja w narzędzia planistyczne przyniesie więcej niż zwiększenie liczby ludzi.
KPI wpływają też na priorytetyzację inwestycji w automatyzację. Zakład, w którym backlog systematycznie rośnie mimo stabilnej obsady, ma silny argument za wdrożeniem CMMS lub predictive maintenance, bo problem nie leży w ludziach, tylko w braku widoczności danych w czasie rzeczywistym. Decyzje podjęte na podstawie zestawu KPI, a nie jednego wskaźnika, rzadziej wymagają korekty po kwartale.
Perspektywa autora: priorytety i pułapki przy wdrażaniu KPI
Na pierwsze 90 dni postawiłbym na trzy rzeczy: jedną wspólną definicję przestoju dla całego zakładu, automatyzację zbierania danych o MTTR i backlogu, i regularny przegląd celów co miesiąc, nie co kwartał. Największa pułapka to wdrażanie dziesięciu KPI naraz, zamiast dopracować trzy i dopiero potem rozszerzać zestaw. Zmiana wskaźników nie działa jak przełącznik. Działa jak iteracja, w której każda korekta uczy Cię czegoś o realnym procesie, nie tylko o liczbach na dashboardzie.
— Mateusz
Pilotaż Synaptix jako praktyczny start do lepszych KPI
Jeśli policzenie i skorygowanie KPI opisanych powyżej wymaga u Ciebie ręcznego eksportowania danych z trzech różnych systemów, problemem nie są wskaźniki, tylko infrastruktura danych. Synaptix-platform integruje dane maszynowe, modele predykcyjne i przepływy dokumentów w jednym środowisku, co oznacza, że MTBF, MTTR czy PMP liczą się z bieżących danych, a nie z arkusza aktualizowanego raz w tygodniu.
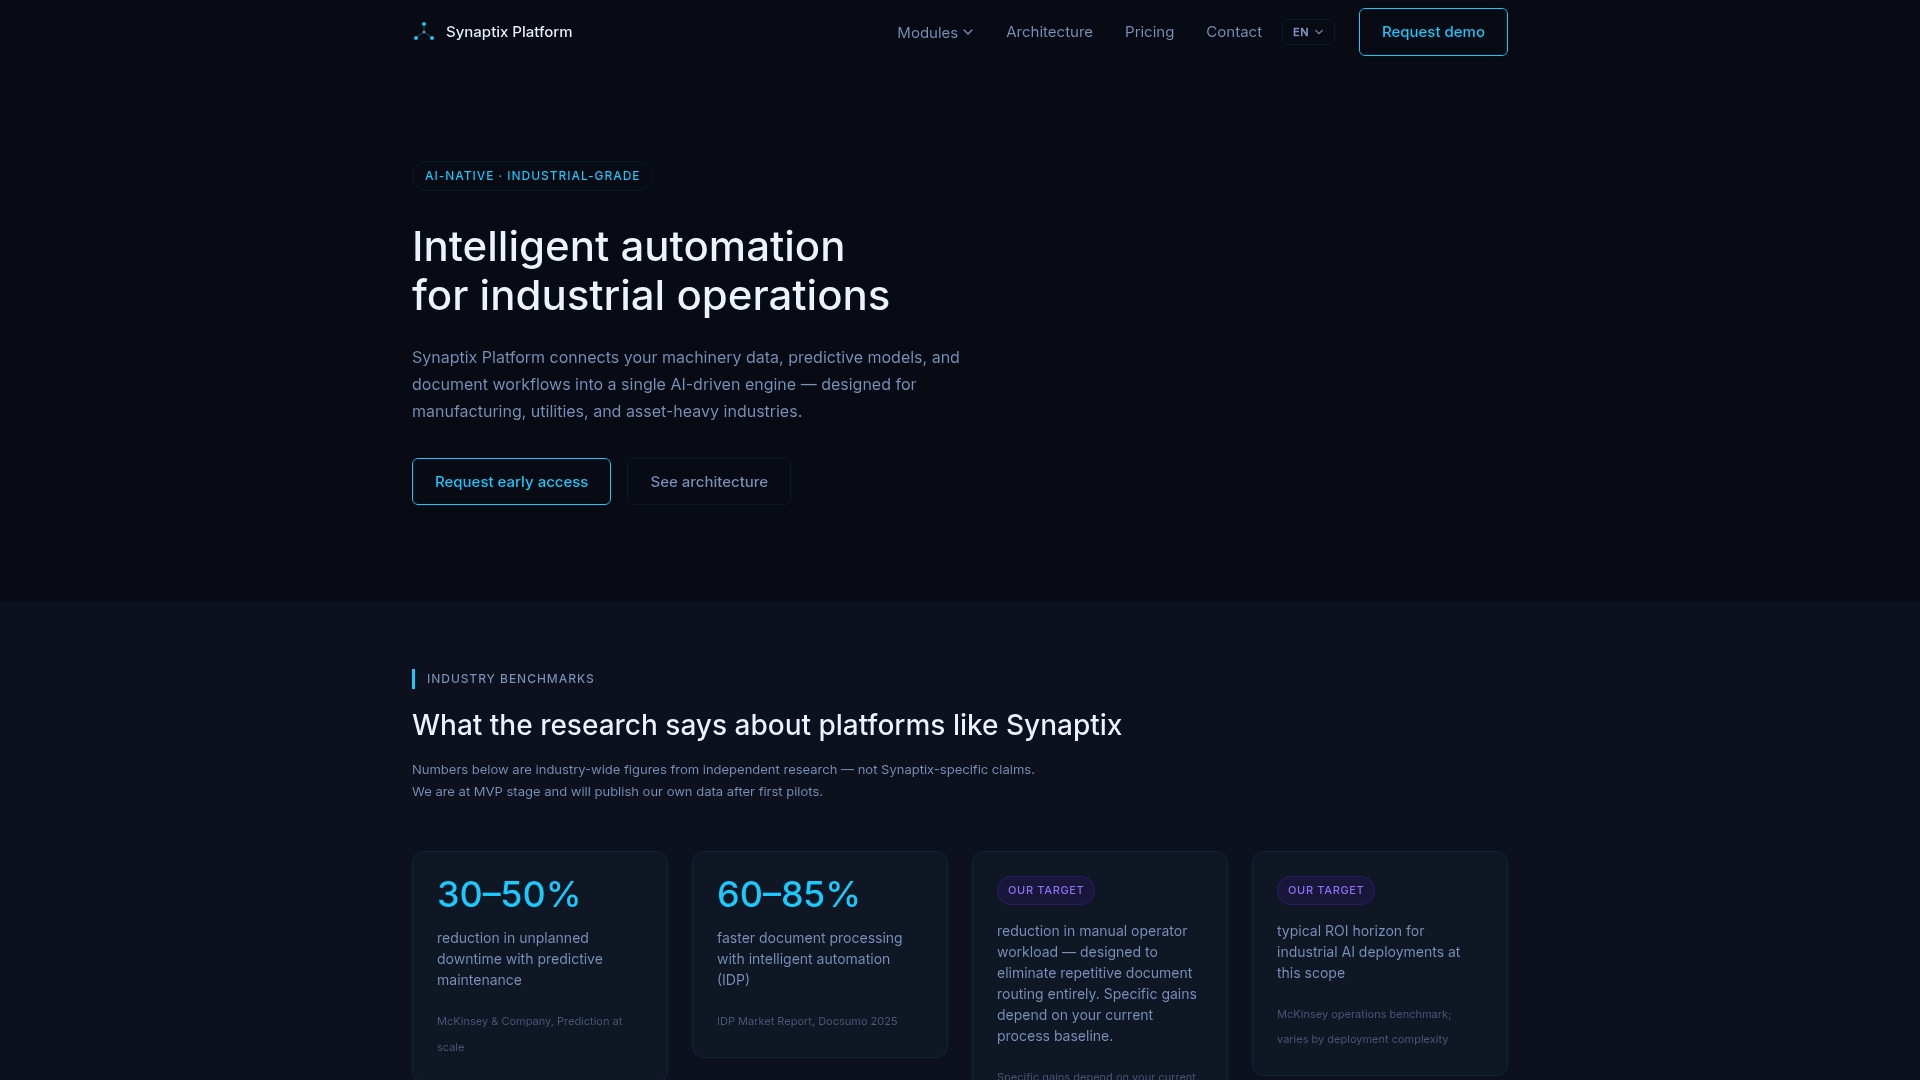
Moduł GridSense zasila dashboard KPI danymi w czasie rzeczywistym, a AutomateFlow automatyzuje przetwarzanie dokumentacji serwisowej, w tym routing do systemów SAP i Maximo, więc zamknięcie zlecenia od razu aktualizuje schedule compliance i backlog. Efekty zależą od stanu wyjściowego zakładu, jakości dostępnych danych historycznych i skali integracji, więc żaden dostawca nie powinien obiecywać identycznego wyniku każdemu klientowi.
Rozsądny pierwszy krok to pilot na jednej linii lub grupie krytycznych maszyn, z jasno zdefiniowaną metryką sukcesu przed startem, dokładnie tak, jak opisano w sekcji o wdrażaniu narzędzi. Sprawdź dostępne plany Pilot, Platform i Enterprise, żeby ocenić, który zakres integracji odpowiada skali Twojego zakładu, i przejrzyj pełny opis platformy, zanim zdecydujesz, od której linii zacząć.
Źródła
Trzy dokumenty warto mieć pod ręką przy budowaniu własnego systemu KPI:
- Tracking Reliability: Metrics that Matter | Reliability and Maintainability Center
- Applying Key Performance Indicators | PNNL
- SMRP best practices: Metrics & Guidelines
- Research article on TPM and reliability (PMC)
Najczęściej zadawane pytania
Jakie są przykładowe wskaźniki KPI w utrzymaniu ruchu?
Najważniejsze to MTBF, MTTR, MTTF i OEE jako wskaźniki niezawodności, oraz PMP, schedule compliance, backlog i koszt utrzymania względem wartości aktywów jako wskaźniki planowania i wykonania. Dobry zestaw łączy KPI wyprzedzające, jak procent realizacji przeglądów zapobiegawczych, z KPI opóźnionymi, jak liczba awarii w miesiącu.
Co to jest TPM w utrzymaniu ruchu?
TPM, czyli total productive maintenance, to podejście łączące konserwację autonomiczną wykonywaną przez operatorów z planowanym utrzymaniem prowadzonym przez techników. Badania nad wdrożeniami TPM pokazują wymierne wzrosty OEE i skrócenie czasu naprawy po wprowadzeniu tego modelu.
Jakie KPI powinni mieć pracownicy działu utrzymania ruchu?
Techniczni pracownicy najlepiej reagują na wskaźniki, na które mają realny wpływ: MTTR, procent zamkniętych zleceń w terminie oraz jakość diagnozy mierzoną wskaźnikiem rework. Wskaźniki poziomu zakładowego, jak koszt utrzymania względem wartości aktywów, należą do kierownictwa, nie do pojedynczego technika.
Jakie są główne KPI w logistyce związane z utrzymaniem ruchu?
W logistyce kluczowe są dostępność sprzętu transportowego i magazynowego, czas przestoju linii sortującej oraz procent zleceń serwisowych zrealizowanych zgodnie z harmonogramem. Te wskaźniki nakładają się na klasyczne KPI produkcyjne, bo przestój przenośnika czy wózka widłowego wpływa bezpośrednio na terminowość dostaw.
Ile KPI powinien śledzić dział utrzymania ruchu na raz?
Nie ma jednej sztywnej liczby, ale praktyka pokazuje, że zestaw skupiony na pięciu do ośmiu kluczowych wskaźnikach, połączonych w warstwy maszyna, linia i zakład, działa lepiej niż rozbudowany dashboard z dwudziestoma metrykami. Zbyt wiele KPI rozprasza uwagę kierowników i utrudnia szybkie podejmowanie decyzji.