
MLOps w przemyśle to zestaw procesów i narzędzi, które utrzymują modele uczenia maszynowego w działaniu ciągłym i ograniczają nieplanowane przestoje. Inwestycja ma sens, gdy model wpływa na realne KPI produkcyjne, działa non stop i wymaga formalnego SLA z utrzymaniem ruchu. Dobrze wdrożony MLOps przekłada się na mniej awarii, szybsze wykrywanie problemów i przewidywalne koszty utrzymania modeli.
Krótko mówiąc:
- Automatyczne monitorowanie driftu modeli i stałe nadzorowanie jakości danych pozwala na szybkie wykrycie spadku skuteczności predykcji i konieczność retreningu.
- Wdrożenie MLOps wymaga np. wersjonowania danych, katalogowania wersji modeli, a także ścisłej integracji z systemami OT, takimi jak OPC‑UA czy MQTT, aby zapewnić stabilne działanie w zakładzie.
- Przy małej skali warto zacząć od minimalnego pilotażu, skupiając się na prostych pipeline'ach i podstawowym monitoringu, zanim zbuduje się pełną platformę korporacyjną.
- W środowiskach o ograniczonym dostępie do internetu i wąskim paśmie, model wdrażany musi mieć support w postaci fail‑safe i procedur awaryjnych, obejmujących testowanie, shadow i canary rollouty.
- Kluczowym czynnikiem sukcesu jest wyznaczenie jasnych właścicieli procesu i odpowiedzialnych za utrzymanie modeli, a nie tylko wybór narzędzi lub platformy.
Spis treści
- Czym jest MLOps w przemyśle i jakie cykle nim rządzą
- Główne komponenty rozwiązania MLOps dla fabryki
- Jakie narzędzia i wzorce działają w praktyce przemysłowej
- Jak wdrożyć MLOps w środowisku OT bez przestojów
- Kto powinien wchodzić w skład zespołu MLOps w zakładzie
- Jak zaplanować pilotaż MLOps krok po kroku
- Jak monitorować drift modeli predykcyjnych i reagować na niego
- Najczęstsze pułapki i sprawdzone praktyki wdrożeń
- Jak Synaptix-platform odpowiada na te wyzwania w praktyce
- Co naprawdę decyduje o sukcesie projektu MLOps
- Synaptix-platform jako punkt startowy dla pilotażu MLOps
- Źródła
- Najczęściej zadawane pytania
Czym jest MLOps w przemyśle i jakie cykle nim rządzą
MLOps to połączenie praktyk DevOps i DataOps z cyklem życia modelu uczenia maszynowego. W fabryce oznacza to coś więcej niż wersjonowanie kodu. Modele muszą działać w środowisku, gdzie dane pochodzą z czujników, sterowników PLC i systemów SCADA, a błąd predykcji może zatrzymać linię produkcyjną.
W praktyce mówimy o trzech przenikających się cyklach:
- Cykl danych — pozyskiwanie z czujników i systemów OT, walidacja jakości, czyszczenie i etykietowanie.
- Cykl modelu — trenowanie, ewaluacja, wersjonowanie i rejestrowanie kandydatów do produkcji.
- Cykl wdrożeniowy — testy przed uruchomieniem, monitoring po wdrożeniu i decyzje o retreningu.
Różnica względem klasycznego MLOps w sektorze internetowym leży w ograniczeniach OT. Sieci przemysłowe mają węższe pasmo, urządzenia bywają odcięte od internetu, a zmiany na linii można wprowadzać tylko w wyznaczonych oknach serwisowych. Model, który w chmurze aktualizuje się co godzinę, w zakładzie chemicznym może czekać na wdrożenie do najbliższego przestoju planowanego. To wymusza inne podejście do testowania i większy nacisk na fail‑safe niż w typowych projektach MLOps.
Główne komponenty rozwiązania MLOps dla fabryki
Stabilne działanie modelu w produkcji zależy od kilku warstw technicznych, które muszą współpracować bez przerwy. Pominięcie jednej z nich zwykle kończy się modelem, który działa dobrze na testach i zawodzi po tygodniu w ruchu.
- Warstwa pozyskiwania i walidacji danych — łączy dane z czujników, PLC i systemów IT (ERP, CMMS), sprawdzając kompletność i zakresy wartości, zanim dane trafią do treningu.
- Feature store — utrzymuje spójne definicje cech używanych zarówno w treningu, jak i w inferencji, eliminując rozjazd między tym, co model widział podczas uczenia, a tym, co dostaje w produkcji.
- Model registry — katalog wersji modeli z metadanymi (dane treningowe, metryki, data walidacji) i statusami: kandydat, w produkcji, wycofany.
- Orkiestracja pipeline'ów — automatyzuje sekwencję trenowanie, walidacja, wdrożenie, tak by każdy krok był powtarzalny i audytowalny.
- CI/CD/CT/CV — ciągła integracja i dostawa kodu, ciągły trening (retraining na nowych danych) i ciągła walidacja (sprawdzanie modelu pod kątem driftu przed każdym wdrożeniem).
Wdrożenie MLOps wymaga przekształcenia prototypów notebookowych w takie właśnie powtarzalne pipeline'y z testami i rejestrami modeli. Bez tego każdy nowy model to osobny, ręczny projekt, a nie proces, który da się skalować na dziesiątki linii produkcyjnych.
Jakie narzędzia i wzorce działają w praktyce przemysłowej
Wybór stacku zależy od skali zakładu, liczby modeli w produkcji i dostępnych kompetencji zespołu. Nie każda fabryka potrzebuje pełnej platformy chmurowej już na starcie.
- Śledzenie eksperymentów i rejestr modeli: MLflow to standardowy wybór open source do wersjonowania artefaktów i rejestrowania modeli, dobrze sprawdzający się w zespołach średniej wielkości. Weights & Biases i Neptune oferują podobne funkcje z mocniejszym naciskiem na wizualizację eksperymentów.
- Serwowanie modeli: TensorFlow Serving i pipeline'y TFX obsługują produkcyjne wdrożenia modeli TensorFlow, natomiast TorchServe pełni analogiczną funkcję dla modeli PyTorch. Konteneryzacja w Kubernetesie ułatwia skalowanie inferencji w wielu lokalizacjach zakładu.
- Platformy end‑to‑end: Azure Machine Learning integruje śledzenie eksperymentów, wdrożenia i monitoring w jednym środowisku, co ma sens przy dużej liczbie modeli i rozproszonych zespołach, ale bywa nadmiarowe dla jednego pilotażu na jednej linii.
- Wersjonowanie danych: DVC, LakeFS lub proste snapshoty katalogów danych pozwalają odtworzyć dokładnie ten zestaw danych, na którym model był trenowany, co jest kluczowe przy audytach jakości.
- Orkiestracja: Prefect, Metaflow, Kedro i Kubeflow różnią się podejściem do integracji lokalnej i chmurowej, więc wybór zależy od tego, gdzie faktycznie stoi infrastruktura zakładu.
Zanim zainwestujesz w pełną automatyzację treningu offline, sprawdź, czy koszty rzeczywiście przewyższają korzyści. Microsoft w swoich wytycznych dla obciążeń AI wprost zaleca taką analizę zamiast automatyzowania wszystkiego z zasady.
Jak wdrożyć MLOps w środowisku OT bez przestojów
Integracja z systemami SCADA i PLC to miejsce, gdzie większość projektów MLOps w przemyśle się wykłada. Model może być technicznie doskonały i wciąż zniszczyć zaufanie do całego programu, jeśli jego wdrożenie zatrzyma linię produkcyjną choćby na kilka minut w nieodpowiednim momencie.
Bezpieczna architektura zwykle opiera się na bramie danych z obsługą OPC‑UA, MQTT lub Modbus, z mechanizmem store‑and‑forward buforującym dane podczas przerw w łączności. Dzięki temu model nie traci danych, gdy sieć zakładowa na chwilę pada, a synchronizacja dogania się po przywróceniu połączenia.
Rollout nowego modelu powinien przejść przez kilka etapów, nie od razu na całą linię:
- Testy FAT/SAT — walidacja modelu w warunkach fabrycznych (Factory Acceptance Test) i na miejscu wdrożenia (Site Acceptance Test), zanim model dotknie realnego procesu.
- Shadow deployment — model działa równolegle z istniejącym procesem, generuje predykcje, ale nie wpływa na decyzje, co pozwala porównać jego zachowanie z rzeczywistością bez ryzyka.
- Canary — nowa wersja obsługuje niewielki wycinek ruchu lub jedną linię, zanim trafi do całego zakładu.
- Blue‑green — dwie wersje środowiska działają równolegle, a przełączenie między nimi jest natychmiastowe i odwracalne w razie problemu.
Każda z tych strategii wymaga fallbacku — jasno zdefiniowanej ścieżki powrotu do poprzedniej wersji modelu albo do reguł opartych na progach ustawionych przez inżynierów, gdy predykcja zawodzi. SLA i SLO trzeba negocjować wspólnie z zespołem utrzymania ruchu, nie narzucać z góry przez dział IT, bo to on odpowiada za skutki przestoju.
Porada profesjonalisty: Zapisuj każdą zmianę modelu w rejestrze z podpisem osoby zatwierdzającej i datą wdrożenia. Przy audycie bezpieczeństwa czy incydencie produkcyjnym to jedyny sposób, by szybko odtworzyć, która wersja modelu działała w danym momencie i kto ją zaakceptował.
Ograniczona łączność i okna serwisowe wymuszają dokumentację, która wykracza poza standardowy MLOps. Wdrożenia przemysłowe wymagają uwzględnienia integracji OT/IT, twardych SLA i procedur awaryjnych już na etapie projektowania architektury, nie jako dodatek po fakcie.
Kto powinien wchodzić w skład zespołu MLOps w zakładzie
Wdrożenie bez jasnego podziału ról kończy się modelem, którym nikt formalnie się nie opiekuje po pierwszych tygodniach.
- MLOps engineer — odpowiada za pipeline'y, orkiestrację i infrastrukturę wdrożeniową.
- ML engineer / data scientist — trenuje modele, ocenia metryki i proponuje kandydatów do produkcji.
- Inżynier OT — zna realia linii produkcyjnej, okna serwisowe i ryzyka związane z integracją.
- DevOps — utrzymuje CI/CD, monitoring infrastruktury i bezpieczeństwo środowiska.
- Właściciel procesu (biznes) — zatwierdza modele do produkcji na podstawie wpływu na KPI, nie tylko metryk technicznych.
SLA i SLO powinny być zapisane w jednym dokumencie referencyjnym, dostępnym dla wszystkich ról, z jasno przypisanym właścicielem odpowiedzialnym za ich egzekwowanie i eskalację przy przekroczeniu progów.
Jak zaplanować pilotaż MLOps krok po kroku
Dobry pilotaż nie testuje technologii w oderwaniu od biznesu. Testuje, czy dany przypadek użycia da się utrzymać w ruchu bez ciągłej ręcznej interwencji.
- Wybierz przypadek użycia z dostępnymi danymi historycznymi, wyraźnym wpływem na KPI i niskim ryzykiem błędu (np. predykcja zużycia energii, nie sterowanie bezpieczeństwem).
- Zbuduj minimalny MLOps: wersjonowanie danych, prosty pipeline treningowy i podstawowy monitoring, zamiast od razu kupować pełną platformę.
- Ustal harmonogram — typowy pilotaż trwa od kilku tygodni do trzech miesięcy, z jasnym punktem decyzyjnym na koniec.
- Zmierz wynik dwutorowo — metryki techniczne (dokładność, czas odpowiedzi) i metryki biznesowe (redukcja przestojów, czas reakcji zespołu utrzymania ruchu).
- Podejmij decyzję o skalowaniu na podstawie tego, czy model utrzymał jakość poza danymi treningowymi i czy zespół był w stanie go obsługiwać bez wsparcia dostawcy.
Porada profesjonalisty: Zanim zaczniesz pilotaż, zapytaj wprost: kto będzie odpowiadał za retrening tego modelu za sześć miesięcy? Jeśli nie masz odpowiedzi, pilotaż skończy się jako ciekawy eksperyment, a nie proces produkcyjny.
Zaczynanie od minimalnego zestawu praktyk MLOps zamiast rozbudowanej platformy zwykle daje szybszy dowód wartości i mniejsze ryzyko odrzucenia projektu przez zarząd po pierwszym kwartale.
Jak monitorować drift modeli predykcyjnych i reagować na niego
Model, który działał dobrze w dniu wdrożenia, po kilku miesiącach może zacząć się mylić, bo zmieniły się warunki produkcji, surowce albo sezonowość. To zjawisko nazywa się driftem i jest jednym z głównych powodów, dla których modele w przemyśle trzeba stale nadzorować, nie tylko wdrożyć raz i zapomnieć.
Monitoring powinien obejmować dwie kategorie metryk:
- Metryki techniczne i jakościowe — czas odpowiedzi (latency), wskaźnik błędów, dokładność (accuracy), F1, a dla modeli regresyjnych MAE lub MAPE.
- Metryki danych — PSI (Population Stability Index) i dywergencja KL do wykrywania zmian w rozkładzie danych wejściowych, a także udział brakujących wartości.
Polityka reakcji zwykle działa na trzech poziomach: przy niewielkim odchyleniu model przechodzi w reżim obserwacji (shadow), przy przekroczeniu progu ostrzegawczego zespół uruchamia retraining, a przy poważnej degradacji następuje automatyczny rollback do poprzedniej wersji. Te progi warto zintegrować z istniejącymi dashboardami do detekcji anomalii, żeby operatorzy widzieli stan modelu w tym samym miejscu, gdzie widzą stan maszyn.
Dlaczego same metryki ML nie wystarczą: w przemyśle kluczowe jest powiązanie wskaźników modelu z metrykami procesu produkcyjnego. Model z idealną dokładnością statystyczną, który nie przekłada się na mniej przestojów albo krótszy czas reakcji serwisu, nie daje wartości biznesowej niezależnie od tego, jak dobrze wypada na papierze.
Najczęstsze pułapki i sprawdzone praktyki wdrożeń
Większość porażek MLOps w przemyśle powtarza kilka tych samych błędów, niezależnie od branży czy wielkości firmy.
- Brak właściciela modelu — nikt formalnie nie odpowiada za retrening, więc model degraduje w ciszy, aż ktoś zauważy problem na produkcji.
- Brak wersjonowania danych — zespół nie może odtworzyć, na czym model był trenowany, co utrudnia diagnozę po incydencie.
- Nadmierna automatyzacja od pierwszego dnia — pełne CI/CD/CT dla jednego modelu pilotażowego to koszt bez uzasadnienia biznesowego.
Sprawdzona checklista gotowości do wdrożenia obejmuje: zdefiniowane SLA/SLO, plan rollback, testy w warunkach zbliżonych do produkcyjnych i jasno przypisaną osobę odpowiedzialną za monitoring po starcie. Zbyt agresywna automatyzacja alarmowania bywa też źródłem zmęczenia alarmami u operatorów, którzy po tygodniu przestają reagować na powiadomienia modelu.
Jak Synaptix-platform odpowiada na te wyzwania w praktyce
Minimalny MLOps rozwiązuje pilotaż na jednej linii. Skalowanie na cały zakład, z dziesiątkami modeli i integracją z systemami CMMS, wymaga zwykle platformy, która przejmuje część tej pracy operacyjnej.
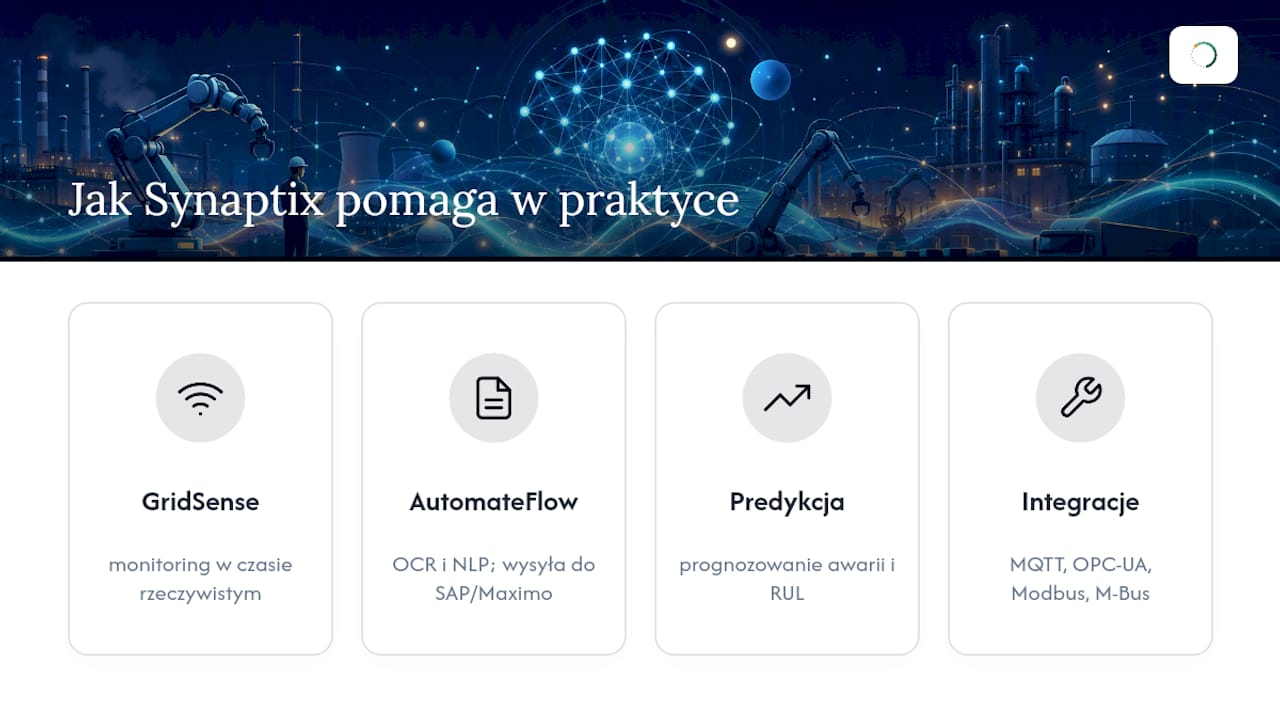
Synaptix-platform buduje na tych samych zasadach, opisanych wcześniej: wersjonowanie, monitoring, governance, ale w formie gotowych modułów. GridSense monitoruje aktywa w czasie rzeczywistym i analizuje strumienie danych z maszyn, co odpowiada bezpośrednio warstwie monitoringu i wykrywania driftu opisanej wyżej. AutomateFlow automatyzuje przetwarzanie dokumentów (OCR, NLP) i kieruje je do systemów SAP czy Maximo, odciążając zespół od ręcznej pracy administracyjnej wokół zleceń serwisowych.
Oprogramowanie pozwala na redukcję nieplanowanych przestojów dzięki predykcyjnemu prognozowaniu awarii i szacowaniu pozostałego czasu życia komponentów (RUL). Integracja z protokołami przemysłowymi MQTT, OPC‑UA, Modbus i M‑Bus pozwala połączyć te predykcje z istniejącą infrastrukturą OT bez budowania mostków od zera, co szczegółowo opisano przy integracji z IBM Maximo.
Dla zakładu, który już przetestował minimalny MLOps i wie, że model wpływa na KPI, platforma tego typu przejmuje warstwę infrastrukturalną, żeby zespół mógł skupić się na samych modelach, nie na budowaniu rejestrów i pipeline'ów od podstaw.
Co naprawdę decyduje o sukcesie projektu MLOps
Największym błędem, jaki widzę w projektach MLOps w przemyśle, nie jest wybór złego narzędzia. Jest odkładanie pytania „kto będzie to utrzymywał za rok” na później. Zespoły wybierają platformę, zanim ustalą właściciela procesu, i dziwią się, gdy model po pół roku nikogo nie interesuje.
Kolejność priorytetów powinna być odwrotna do tej, którą widzę najczęściej: najpierw dane i ich wersjonowanie, potem monitoring, na końcu rozbudowane governance. Firmy robią to w odwrotnej kolejności, bo governance brzmi bardziej strategicznie na spotkaniu zarządu.
Zacznij od jednego mierzalnego pilotażu z jasnym kryterium sukcesu, nie od platformy na cały zakład. Mniejsza skala oznacza mniejsze ryzyko i szybszy dowód, że warto inwestować dalej.
— Mateusz
Synaptix-platform jako punkt startowy dla pilotażu MLOps
Budowanie minimalnego MLOps od zera, ze skompletowaniem rejestru modeli, bramy OPC‑UA i dashboardu monitoringu, zajmuje zespołowi wewnętrznemu zwykle więcej czasu niż sam pilotaż modelu. Synaptix-platform daje te elementy jako gotowe moduły, więc pilotaż zaczyna się od danych i modelu, nie od budowania infrastruktury.
Moduł GridSense obsługuje ciągły monitoring aktywów i wykrywanie anomalii, a AutomateFlow pomaga zautomatyzować przetwarzanie dokumentacji serwisowej i routing do systemów takich jak SAP czy Maximo. Zamiast wybierać między pełną platformą chmurową a zestawem rozproszonych bibliotek open source, oferowane jest jedno środowisko z integracją protokołów przemysłowych. Jeśli rozważasz pilotaż predykcyjnego utrzymania ruchu w swoim zakładzie, sprawdź ofertę pilotażową Synaptix-platform i umów rozmowę o zakresie wdrożenia dopasowanym do skali twojej linii produkcyjnej.
Źródła
Dla głębszego zrozumienia tematu warto sięgnąć po dokumentację Azure Well‑Architected Framework dla obciążeń AI, oficjalną stronę MLflow oraz przewodnik po TensorFlow Serving. Praktyczne case'y integracji z systemami przemysłowymi znajdziesz w materiałach o AI w utrzymaniu ruchu i ekstrakcji danych z dokumentów PDF. Kwestie logistyki dostaw komponentów przy planowaniu wdrożeń opisuje artykuł o etapach przewozu kontenerów.
- Metodyki MLOps i GenAIOps dla obciążeń sztucznej inteligencji na platformie Azure - Microsoft Learn
- MLflow
- TensorFlow Serving — TFX guide
- MLOps dla przemysłu: jak wdrażać modele, monitorować drift i utrzymać SLA
- Praktyczny przewodnik po MLOps: jak zautomatyzować wdrażanie modeli AI w środowisku produkcyjnym
Najczęściej zadawane pytania
Jakie są rodzaje modeli uczenia maszynowego w przemyśle?
W zakładach produkcyjnych najczęściej stosuje się modele predykcyjne (prognoza awarii, RUL), modele klasyfikacyjne (wykrywanie defektów) oraz modele detekcji anomalii do monitoringu energii i pracy maszyn.
Czym różni się machine learning od sztucznej inteligencji?
Sztuczna inteligencja to szersza dziedzina obejmująca każdy system symulujący ludzkie zdolności decyzyjne, a uczenie maszynowe to jej podzbiór, w którym model uczy się wzorców z danych bez ręcznie zaprogramowanych reguł.
Jakie są przykłady zastosowania uczenia maszynowego w fabrykach?
Typowe zastosowania to predykcyjne utrzymanie ruchu, wykrywanie anomalii w zużyciu energii, automatyzacja przetwarzania dokumentów serwisowych i optymalizacja harmonogramów konserwacji na podstawie prognozowanego czasu życia komponentów.
Kiedy warto wdrożyć pełną platformę MLOps, a kiedy wystarczy minimalna wersja?
Minimalny MLOps (wersjonowanie danych, prosty pipeline, podstawowy monitoring) wystarcza na etapie pilotażu jednego modelu. Pełna platforma ma sens, gdy liczba modeli w produkcji rośnie i potrzebujesz jednego środowiska governance dla całego zakładu, jak w przypadku modułów Synaptix-platform.
Co powoduje drift modeli predykcyjnych w przemyśle?
Drift powstaje, gdy zmieniają się warunki produkcji: nowe surowce, sezonowość, modernizacja maszyn lub zmiana procesu, przez co dane wejściowe zaczynają odbiegać od tych, na których model był trenowany.