
Tak, zaawansowane OCR z warstwą layout-aware i modelami językowymi realnie automatyzuje dokumentację techniczną, a pilotaż można uruchomić w ciągu kilku tygodni. Efekt: krótszy czas wyszukiwania procedur, mniej ręcznego przepisywania danych do CMMS i solidniejszy ślad audytowy. Warunek jest jeden — zacznij od wąskiego zakresu dokumentów, zwaliduj wyniki z zespołem utrzymania, dopiero potem skaluj.
Krótko mówiąc:
- Zaawansowane OCR layout-aware z modelami językowymi poprawia dokładność ekstrakcji do ponad 94%, znacząco przewyższając tradycyjne podejścia.
- Pilotaż można uruchomić w ciągu 6-8 tygodni, zaczynając od wąskiego zakresu dokumentów i stopniowo skalując na podstawie wyników.
- Kluczowe jest mapowanie wyekstrahowanych danych do schematów systemów CMMS lub ERP oraz zapewnienie śladu audytowego zgodnego z normami.
- Unikaj pełnego trenowania jednego modelu na wszystkie dokumenty, zamiast tego stosuj osobne modele dla różnych rodzajów układów dokumentów.
- Błędy w OCR eliminują próby automatycznego wypełniania baz danych, gdyż model halucynacji i zmiany struktur dokumentów wymagają stałej walidacji i kontroli.
Spis treści
- Czym się różnią dokumenty techniczne i dlaczego standardowy OCR zawodzi
- Nowoczesne podejścia: layout-aware OCR, LLM i knowledge graph
- Integracja z CMMS/ERP: mapowanie pól i ślad audytowy
- Checklista pilotażu i przykładowy harmonogram wdrożenia
- Ryzyka i walidacja: jak zapobiegać regresji jakości
- Dowody Synaptix: wdrożenia i konkretne rezultaty
- Perspektywa autora: negocjowanie pilotażu i oczekiwania biznesowe
- Jak zacząć pilotaż OCR dokumentów technicznych z Synaptix
- Źródła
- Najczęściej zadawane pytania
Czym się różnią dokumenty techniczne i dlaczego standardowy OCR zawodzi
Dokumentacja techniczna to nie faktury czy umowy z jednolitym układem tekstu. Rysunki złożeniowe, schematy elektryczne, raporty inspekcyjne z checkboxami, formularze zleceń pracy z wielokolumnowymi tabelami — każdy z tych typów ma inną logikę wizualną. Klasyczny OCR odczytuje znaki, ale nie rozumie, że pole w prawym górnym rogu to numer zlecenia, a kolumna trzecia w tabeli to kod części zamiennej.
To fundamentalny problem: OCR zamienia obraz na tekst, ale nie mapuje tego tekstu na strukturę biznesową, której potrzebuje system CMMS czy ERP. W praktyce oznacza to, że nawet przy 99% poprawnie odczytanych znaków dane trafiają w złe pola albo w ogóle nie trafiają do systemu.
Konsekwencje widać szybko:
- błędne dane w zleceniach pracy, które technik odkrywa dopiero w terenie,
- godziny ręcznych poprawek po stronie administracji utrzymania ruchu,
- ryzyko niezgodności podczas audytu, gdy brakuje spójnego śladu, skąd pochodzi dana wartość.
Techniczy branży lotniczej i przemysłowej tracą znaczną część czasu pracy na samo wyszukiwanie właściwej procedury czy instrukcji serwisowej w archiwach dokumentów — zanim jeszcze zaczną naprawę. Skanowanie dokumentów technicznych bez warstwy rozumienia układu tylko przenosi ten problem z papieru do cyfrowego archiwum.
Nowoczesne podejścia: layout-aware OCR, LLM i knowledge graph
Różnica między tradycyjnym OCR a nowoczesnym podejściem polega na dodaniu dwóch warstw: rozpoznawania układu strony i interpretacji semantycznej. Modele layout-aware, takie jak LayoutLMv3, uczą się rozpoznawać nie tylko tekst, ale jego pozycję względem tabel, pól formularzy i elementów graficznych. Dotrenowanie takiego modelu na około 20 przykładowych stronach z danej rodziny układów dokumentów wystarcza, by system zaczął poprawnie wykrywać strukturę nowych, podobnych plików.
Cały przepływ wygląda tak:
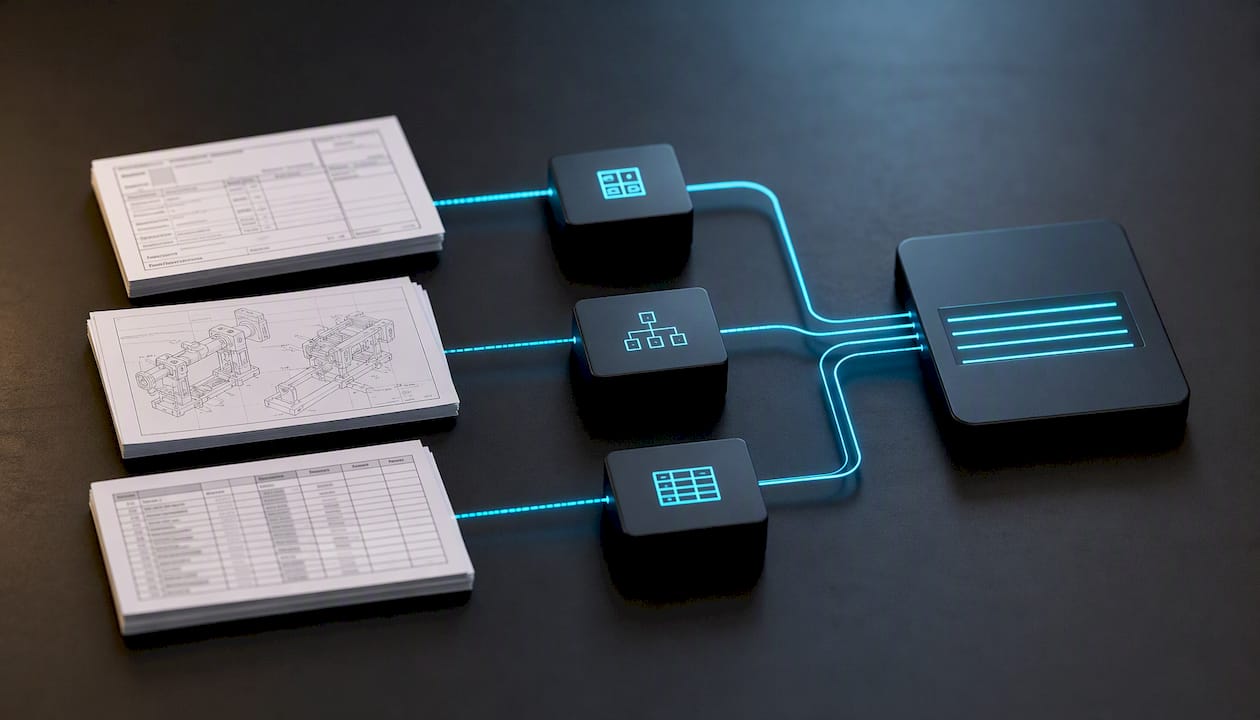
- ekstrakcja tokenów tekstowych i ich współrzędnych na stronie,
- podział na fragmenty (chunking) odpowiadające logicznym sekcjom dokumentu,
- parsowanie tych fragmentów przez model językowy, który przypisuje wartości do konkretnych pól,
- budowa grafu wiedzy łączącego urządzenie, zlecenie, część i historię serwisową.
Efekt tej architektury potwierdzają badania: podejście łączące layout-aware OCR z LLM osiągnęło dokładność ekstrakcji na poziomie 94,2% wobec 62,3% dla tradycyjnego OCR w testach na złożonych dokumentach technicznych. To nie kosmetyczna poprawa — to różnica między systemem, któremu można zaufać, a takim, który wymaga sprawdzania każdego rekordu.
Porada profesjonalisty: Nie trenuj jednego uniwersalnego modelu na wszystkich typach dokumentów naraz. Osobne, mniejsze modele dla rodzin układów (karty inspekcyjne, rysunki złożeniowe, formularze zleceń) uczą się szybciej i mniej zawodzą przy odchyleniach.
Integracja z CMMS/ERP: mapowanie pól i ślad audytowy
Sama ekstrakcja danych z dokumentu to połowa pracy. Druga połowa to dopasowanie wyekstrahowanych wartości do schematu pól, których oczekuje SAP PM czy IBM Maximo — identyfikator urządzenia, numer zlecenia pracy, kod części, data wykonania czynności. Bez jasnej mapy pól nawet doskonała ekstrakcja wyląduje jako nieużyteczny plik tekstowy.
Praktyczne wdrożenie wymaga kilku decyzji:
- Wybór trybu integracji. API synchroniczne daje natychmiastowy zapis do systemu, ale wymaga stabilnego połączenia i dobrze zaprojektowanej obsługi błędów. Tryb batch jest odporniejszy na awarie sieci, ale opóźnia widoczność danych o godziny.
- Mechanizm retry i rollback. Każda nieudana synchronizacja musi być logowana i możliwa do ponowienia bez duplikowania rekordów w CMMS.
- Wersjonowanie dokumentacji technicznej. Każda wersja rysunku, instrukcji czy schematu potrzebuje unikalnego identyfikatora i historii zmian, inaczej kontrola wersji dokumentów rozpada się przy pierwszej aktualizacji normy.
Ślad audytowy nie jest opcjonalnym dodatkiem. Semantyczne dopasowanie danych operacyjnych do standardowych modeli danych, takich jak Asset Administration Shell, ułatwia zgodność z wymogami regulacyjnymi i pozwala wykazać, skąd pochodzi każda wartość w systemie. To bezpośrednio przekłada się na czas przygotowania do audytu jakości.
Checklista pilotażu i przykładowy harmonogram wdrożenia
Pilotaż OCR dokumentów technicznych da się przeprowadzić w tygodniach, nie miesiącach, pod warunkiem że zakres jest wąski i role są jasno przypisane od pierwszego dnia — praktyczne wdrożenie z przykładami.
- Tydzień 1-2: zbiór próbek. Wybierz jedną rodzinę dokumentów (np. karty inspekcyjne jednego typu urządzenia) i zbierz 20-50 reprezentatywnych plików.
- Tydzień 3-4: budowa i trening modelu layout. Model uczy się rozpoznawać strukturę na próbkach, zespół IT przygotowuje endpointy testowe.
- Tydzień 5-6: integracja testowa z CMMS. Wyekstrahowane dane trafiają do środowiska testowego SAP PM lub Maximo, zespół utrzymania sprawdza poprawność mapowania pól.
- Tydzień 7-8: akceptacja i decyzja o skalowaniu. Porównanie metryk z progiem akceptacji, decyzja o rozszerzeniu na kolejne typy dokumentów.
Dane z badań: systemy semantycznego wyszukiwania i retrieval wspomagany modelami językowymi skracają czas dotarcia do właściwej procedury MRO z kilku minut do około 18 sekund przy skuteczności powyżej 90% w testach top-10. To realny punkt odniesienia przy ustalaniu własnych metryk pilotażu.
Trzy metryki warto śledzić od pierwszego dnia: dokładność ekstrakcji (odsetek poprawnie rozpoznanych pól), czas od wgrania dokumentu do pojawienia się rekordu w CMMS oraz odsetek rekordów wymagających ręcznej poprawki. Role rozkładają się naturalnie: IT odpowiada za bezpieczeństwo endpointów i infrastrukturę, zespół utrzymania ruchu za merytoryczną walidację danych, dział zgodności za dokumentację audytową, a dostawca rozwiązania za dostrojenie modelu do konkretnych układów dokumentów.
Ryzyka i walidacja: jak zapobiegać regresji jakości
Największym zagrożeniem w systemach opartych na LLM jest halucynacja — model potrafi wygenerować wiarygodnie brzmiącą wartość, która nie ma pokrycia w oryginalnym dokumencie. Drugie ryzyko to zmiana układu dokumentów, gdy dostawca sprzętu wprowadza nowy szablon karty serwisowej, a model nie rozpoznaje już struktury. Trzecie to brak metadanych, przez co wyekstrahowane dane trudno powiązać z konkretnym urządzeniem czy zleceniem.
Skuteczna walidacja opiera się na trzech mechanizmach:
- próbkowanie z udziałem człowieka (human-in-the-loop) na losowej części rekordów przed pełnym zaufaniem systemowi,
- próg ufności modelu, poniżej którego rekord trafia do ręcznej weryfikacji zamiast automatycznego zapisu,
- testy regresyjne uruchamiane przy każdej zmianie szablonu dokumentu, zanim trafi on do produkcji.
Procedura eskalacji powinna być prosta: jeśli odsetek błędów przekracza ustalony próg SLA, system wstrzymuje automatyczny zapis do CMMS i kieruje partię dokumentów do przeglądu zespołu utrzymania.
Dowody Synaptix: wdrożenia i konkretne rezultaty
Synaptix Platform integruje dane maszynowe, modele predykcyjne i przetwarzanie dokumentów w jednym silniku AI. Moduł GridSense monitoruje stan aktywów w czasie rzeczywistym, a AutomateFlow odpowiada za automatyzację przepływu dokumentów, w tym OCR i routing danych do SAP oraz Maximo.
W praktyce oznacza to konkretne, mierzalne rezultaty. Ekstrakcja danych z PDF dla utrzymania ruchu została wdrożona w tygodniach, nie kwartałach. Projekt synchronizacji czasu między systemami OT i IT zamknął się w 16 tygodni. Dowody audytowe wymagane przez normę ISO 50001 dało się dostarczyć w dniach, a nie tygodniach oczekiwania na ręczne zestawienie dokumentacji.
Dla decydenta oceniającego pilotaż te liczby przekładają się bezpośrednio na harmonogram projektu i ryzyko budżetowe. Krótki czas wdrożenia oznacza, że pierwsze wyniki są dostępne, zanim skończy się kwartał.
Perspektywa autora: negocjowanie pilotażu i oczekiwania biznesowe
Największym błędem, jaki widzę przy takich projektach, jest próba objęcia pilotem od razu wszystkich typów dokumentów. Zacznij od jednej rodziny układów, jednego systemu docelowego i jasno zdefiniowanego progu sukcesu. CFO nie potrzebuje slajdu o sztucznej inteligencji, potrzebuje liczby godzin zaoszczędzonych miesięcznie i realnego horyzontu zwrotu. Zaplanuj też budżet czasu na adaptację schematów danych, bo layout dokumentów zmienia się częściej, niż zakłada harmonogram projektu.
— Mateusz
Jak zacząć pilotaż OCR dokumentów technicznych z Synaptix
Synaptix Platform oferuje coś, czego brakuje w większości wdrożeń OCR: gotową ścieżkę od skanu dokumentu do rekordu w systemie utrzymania ruchu, bez miesięcy integracji od zera.
Pilot obejmuje pełny cykl: ekstrakcję danych z PDF, mapowanie pól do schematu CMMS, walidację wyników z zespołem utrzymania oraz przygotowanie dowodów audytowych. Moduł AutomateFlow trafia bezpośrednio do integracji z SAP PM lub IBM Maximo, więc pilotaż nie kończy się na demo, tylko realnie zasila systemy, z których korzysta zespół utrzymania na co dzień. Firmy z sektora produkcyjnego i użyteczności publicznej zyskują punkt startowy z mierzalnym harmonogramem, a nie obietnicę wdrożenia „kiedyś w przyszłości”.
Jeśli zarządzasz dokumentacją techniczną w skali, która przerasta możliwości ręcznego przetwarzania, zgłoś zespół do pilotażu Synaptix i ustal razem z nami zakres pierwszej partii dokumentów.
Źródła
Dokładność podejścia layout-aware potwierdza badanie Digidoc nad ekstrakcją danych z złożonych dokumentów PDF. Architekturę łączącą bazy wektorowe z grafami wiedzy opisuje wdrożenie Infosys na platformie Amazon Bedrock. Zastosowanie generatywnej AI do strukturyzacji zapisów utrzymania omawia publikacja w MDPI Applied Sciences, a semantyczne dopasowanie danych do standardów przemysłowych opisuje praca o dopasowaniu OPC UA do Asset Administration Shell.
- A Compliance-Preserving Retrieval System for Aircraft MRO Task Search
- Semantic matching of OPC UA and operational manuals to Asset Administration Shells
Najczęściej zadawane pytania
Czym różni się OCR dokumentów technicznych od zwykłego OCR?
Zwykły OCR zamienia obraz na tekst, natomiast OCR dokumentów technicznych dodatkowo rozpoznaje układ strony, tabele i pola formularzy, dzięki czemu dane trafiają do właściwych pól w systemach CMMS i ERP.
Ile trwa wdrożenie pilotażu OCR w firmie produkcyjnej?
Przy wąskim zakresie jednej rodziny dokumentów pilotaż da się przeprowadzić w 6-8 tygodni, od zebrania próbek po integrację testową z systemem docelowym.
Jaka dokładność ekstrakcji jest realna przy dokumentach technicznych?
Podejścia łączące layout-aware OCR i modele językowe osiągają w badaniach dokładność na poziomie 94,2% wobec 62,3% dla tradycyjnego OCR.
Czy OCR dokumentów technicznych integruje się z SAP PM lub IBM Maximo?
Tak, wyekstrahowane dane można mapować do pól tych systemów przez API synchroniczne lub tryb batch, z zachowaniem logów i mechanizmu ponawiania przy błędach synchronizacji.
Jak zapobiegać błędom generowanym przez modele językowe w OCR?
Kluczowe są próbkowanie z udziałem człowieka, próg ufności poniżej którego rekord trafia do ręcznej weryfikacji, oraz testy regresyjne przy każdej zmianie szablonu dokumentu.