
Wdrożenie offline‑first PWA z delta sync, Service Worker i IndexedDB, kolejką operacji w outboxie i redundantnymi wyzwalaczami synchronizacji to jedyny wzorzec, który wytrzymuje realne warunki hali produkcyjnej. Technik pracuje lokalnie, dane czekają w kolejce z własnym identyfikatorem i wersją, a synchronizacja rusza przez Background Sync, ping albo ręczny przycisk, gdy sieć wróci. Status synchronizacji musi być widoczny na ekranie, bo pracownik w hali bez łącza nie wybaczy aplikacji, która „gdzieś tam” wysyła dane w tle.
Krótko mówiąc:
- Synchronizacja offline opiera się na Service Worker, IndexedDB i kolejce operacji outbox, co zapewnia niezawodność przy realnych warunkach hal produkcyjnych.
- Delta sync zmniejsza zużycie transferu i baterii, a konfiguracja interwałów powinna być dostosowana do charakteru danych, z priorytetem dla danych krytycznych.
- Konflikty danych rozwiązuje się przez logikę biznesową, a nie automatyczne last‑write‑wins, szczególnie dla pól decyzyjnych, co wymaga rekoncyliacji przez menedżera.
- System musi mieć redundantne mechanizmy syncu, łącznie z Background Sync, pingami i manualnym wyzwalaniem, aby działał stabilnie w różnych warunkach sieciowych.
- Przy wdrożeniu konieczne jest ograniczenie złożoności architektury offline, testy offline, wizualizacja stanu synchronizacji i odpowiednie zabezpieczenia danych.
Spis treści
- Zarys architektury synchronizacji offline zleceń: komponenty i role
- Jak skonfigurować interwały i limity transferu w synchronizacji danych offline?
- Model danych offline i reguły rozwiązywania konfliktów w zleceniach serwisowych
- Checklist wdrożeniowy: jak zsynchronizować zlecenia przed produkcją
- Perspektywa autora: dlaczego redundancja mechanizmów sync się opłaca
- Jak Synaptix Platform wspiera wdrożenie synchronizacji offline zleceń
- Źródła
- Najczęściej zadawane pytania
Zarys architektury synchronizacji offline zleceń: komponenty i role
Trzy elementy odpowiadają za działanie synchronizacji offline zleceń w praktyce: Service Worker, IndexedDB i outbox operacji. Bez żadnego z nich cały mechanizm sypie się przy pierwszym realnym teście w terenie.
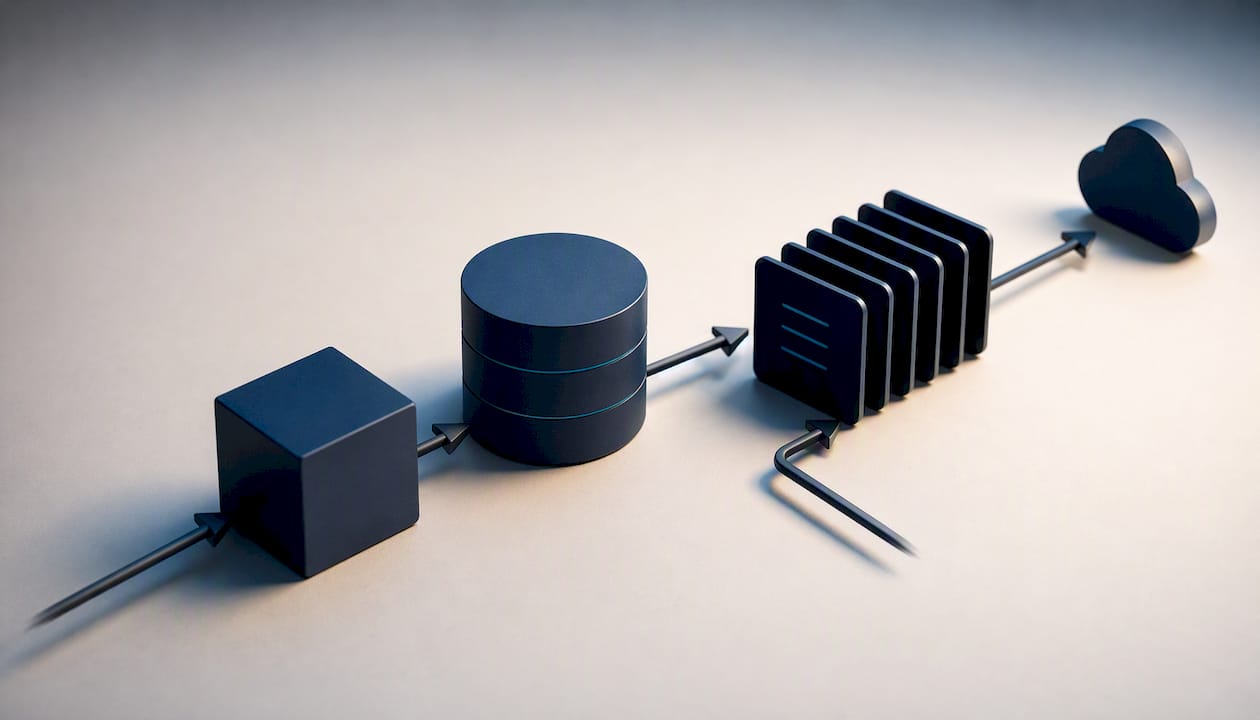
Service Worker przechwytuje żądania sieciowe i decyduje, czy obsłużyć je z cache, czy przepuścić do sieci. To on odpowiada za instalowalność aplikacji i działanie po zamknięciu przeglądarki, a razem z IndexedDB tworzy fundament architektury lokalnej, w której dane żyją najpierw na urządzeniu, a potem dopiero w chmurze, jak opisuje analiza architektury PWA typu local‑first. IndexedDB przechowuje zarówno pobrane zlecenia, jak i outbox, czyli kolejkę operacji czekających na wysyłkę.
Outbox to nie zrzut danych, a log zdarzeń. Każda operacja w kolejce potrzebuje:
- unikalnego identyfikatora operacji (nie rekordu),
- znacznika czasu utworzenia,
- statusu (oczekująca, w trakcie, zakończona, błąd),
- numeru wersji rekordu, na którym operacja została wykonana.
Same PWA nie wystarczy bez odpowiedniego zestawu API: manifest, zarejestrowany Service Worker po HTTPS i, opcjonalnie, Push API do powiadomień dla techników w terenie, jak podkreśla przegląd projektowania ERP mobilnego offline‑first. Do wyzwalania synchronizacji warto łączyć kilka mechanizmów naraz: Background Sync API, ping do endpointu sprawdzającego stan łącza, okresowe sprawdzanie w tle i przycisk manualnego syncu dla technika.
Integracja z CMMS czy ERP musi być transakcyjna. System po stronie serwera powinien zwracać nie ogólny błąd, a szczegółową informację, które operacje w batchu się powiodły, a które odpadły z konkretnym powodem walidacji. Bez tego frontend nie wie, co powtórzyć, a co odrzucić na stałe.
Jak skonfigurować interwały i limity transferu w synchronizacji danych offline?
Delta sync, czyli przesyłanie tylko zmian od ostatniej synchronizacji, jest podstawą każdej sensownej strategii offline dla aplikacji terenowych. Pełny download całej bazy przy każdym połączeniu to najszybszy sposób na spalenie transferu i baterii urządzenia w terenie.
Konfiguracja interwałów zależy od charakteru danych, nie od jednej reguły dla całej aplikacji:
- Zlecenia przypisane do technika i harmonogram dnia: synchronizacja co kilka do kilkunastu minut, gdy jest łącze.
- Dane referencyjne (katalog części, procedury, checklisty): interwał liczony w godzinach, nawet raz na dobę.
- Historia zleceń i archiwum: filtr czasowy obejmujący ostatni okres, a nie pełną historię, z rzadszym odświeżaniem.
- Dane krytyczne (statusy awarii, priorytety): synchronizacja przy każdej dostępnej okazji, niezależnie od harmonogramu.
Filtry czasowe najlepiej ustawiać na sztywnych granicach, na przykład bieżący miesiąc plus miesiąc następny, a nie na przesuwnym oknie liczonym od „teraz”, bo to znacznie prościej testować i debugować, jak wskazuje druga część wskazówek Microsoftu o pracy offline.
Batch versus incremental to fałszywy wybór. Sprawdza się podejście hybrydowe: wysyłka w batchach po kilku operacjach na raz, z automatycznym fallbackiem do wysyłki pojedynczej, gdy batch odpada z błędem, co potwierdza doświadczenie z wdrożeń PWA w magazynach. Retry powinien działać na exponential backoff, a każda operacja w outboksie musi mieć własny status, żeby jeden błąd nie blokował całej kolejki.
Porada profesjonalisty: Włącz opcję „synchronizuj tylko przez Wi‑Fi” jako domyślną dla dużych załączników (zdjęcia, skany protokołów), a dla samych rekordów zleceń zostaw synchronizację przez dowolne łącze. To jedno ustawienie ratuje limity danych techników korzystających z sieci komórkowej.
Model danych offline i reguły rozwiązywania konfliktów w zleceniach serwisowych
Konflikt danych w trybie offline nie jest wyjątkiem, jest codziennością. Dwóch techników edytujących to samo zlecenie, dyspozytor zmieniający priorytet w tym samym czasie, gdy urządzenie w terenie jest offline, to standardowy dzień pracy w utrzymaniu ruchu.
Prosty last‑write‑wins działa tylko dla pól o niskim ryzyku, jak notatka tekstowa czy status „w drodze”. Dla pól decyzyjnych, takich jak koszt naprawy, przypisany zasób czy status zamknięcia zlecenia, last‑write‑wins jest błędem projektowym. Reguła biznesowa powinna wymuszać rekoncyliację przez menedżera, gdy wersja rekordu na serwerze różni się od wersji, na której pracował technik offline, zgodnie z zasadą, że konflikty w architekturze local‑first wymagają logiki biznesowej, nie automatycznego rozstrzygania.
Praktyczny model danych do synchronizacji offline zleceń obejmuje:
- outbox jako log operacji (co zrobiono), nie jako zrzut stanu (co jest teraz),
- stały identyfikator operacji niezmienny przez cały cykl życia rekordu,
- numer wersji rekordu przypisany przy każdym zapisie lokalnym,
- kolejkę FIFO respektującą zależności między operacjami (np. najpierw utworzenie zlecenia, potem dodanie do niego notatki),
- detekcję cykli zależności, żeby dwie powiązane operacje nie blokowały się wzajemnie,
- TTL ustawiony per typ danych, z krótszym czasem życia dla danych zmiennych i dłuższym dla katalogów referencyjnych.
Zależności między operacjami to często pomijany szczegół. Jeśli technik offline tworzy nowe zlecenie i natychmiast dodaje do niego zdjęcie, kolejka musi wiedzieć, że drugą operację można wysłać tylko po potwierdzeniu pierwszej. Bez tego serwer dostaje odwołanie do rekordu, który jeszcze nie istnieje.
Checklist wdrożeniowy: jak zsynchronizować zlecenia przed produkcją
Konfiguracja offline profile zaczyna się od ograniczenia zakresu, nie od jego rozszerzania. Każda dodatkowa relacja między tabelami w profilu offline zwiększa czas pierwszej synchronizacji i ryzyko błędów. Ograniczenie złożoności zapytań po stronie serwera bywa skuteczniejsze niż dalsze filtrowanie liczby rekordów, jak pokazuje trzecia część wskazówek Microsoftu.
Zestaw testów przed wdrożeniem produkcyjnym:
- Tryb samolotowy podczas pełnego cyklu pracy technika, od odbioru zlecenia do zamknięcia.
- Przerwanie wysyłki w połowie synchronizacji i sprawdzenie, czy kolejka wraca do konsekwentnego stanu.
- Restart aplikacji z niezsynchronizowanymi operacjami w outboksie.
- Symulacja braku miejsca na urządzeniu przy zapisie do IndexedDB.
- Długi offline, dużą liczbę operacji w kolejce, zsynchronizowaną jednorazowo po powrocie łącza.
Interfejs musi pokazywać stan synchronizacji bez pytania: liczbę oczekujących operacji, czas ostatniego udanego syncu, pasek postępu dla dłuższych transferów i przycisk manualnego wywołania synchronizacji. Bezpieczeństwo danych lokalnych wymaga szyfrowania pamięci urządzenia, polityki MDM z opcją zdalnego wymazania danych i limitu czasu sesji offline, po którym aplikacja wymaga ponownego logowania przy pierwszym dostępnym łączu.
Porada profesjonalisty: Zmiany schematu danych grupuj w rzadkie, zaplanowane wydania, a nie w ciągłe drobne aktualizacje. Każda zmiana struktury tabeli w profilu offline wymusza ponowne pobranie całej tabeli u każdego technika, a to przy stu urządzeniach w terenie potrafi zablokować sieć na cały dzień.
Perspektywa autora: dlaczego redundancja mechanizmów sync się opłaca
Największe wpadki widziałem tam, gdzie backend i hala mówiły o „tym samym” zleceniu, ale z innym rozumieniem jego stanu. Dokumentacja zakładała, że pole jest opcjonalne, a technik w terenie wypełniał je zawsze, bo taki był zwyczaj brygady.
Pojedynczy mechanizm wyzwalania synchronizacji zawodzi w realnych warunkach, więc łączenie Background Sync z pingiem i manualnym przyciskiem nie jest przesadną ostrożnością, tylko minimum. I najważniejsze: powiedz użytkownikom wprost, że offline oznacza ograniczony zakres funkcji. Aplikacja, która obiecuje pełną funkcjonalność bez sieci, kończy jako aplikacja, której nikt nie ufa po pierwszym poważnym błędzie synchronizacji.
— Mateusz
Jak Synaptix Platform wspiera wdrożenie synchronizacji offline zleceń
Zaprojektowanie kolejki outbox, reguł konfliktów i redundantnych wyzwalaczy syncu to jedno. Połączenie tego z rzeczywistymi danymi maszyn i predykcją awarii to zupełnie inna skala projektu.
Moduł GridSense monitoruje aktywa w czasie rzeczywistym, a AutomateFlow automatyzuje przetwarzanie dokumentacji serwisowej, odciążając zespoły od pracy ręcznej przy wprowadzaniu danych z terenu. Pilotaż obejmuje konfigurację profilu offline dopasowanego do konkretnych typów zleceń, integrację kolejki outbox z istniejącym CMMS lub ERP oraz testy w terenie z pomiarem realnych metryk synchronizacji, nie tylko deklaracji dostawcy. Jeśli odpowiadasz za niezawodność obsługi zleceń serwisowych w swojej organizacji, sprawdź platformę Synaptix i zapytaj o warunki wdrożenia pilotażowego dopasowanego do Twojej skali operacji.
Źródła
Więcej o synchronizacji czasu OT i mobilnych zleceniach w Maximo znajdziesz w powiązanych materiałach, a temat integracji z IBM Maximo rozwija kwestie łączenia PWA z systemami CMMS.
- Best practices for offline mode in the Field Service Mobile app — part 1
- Local-first PWA architecture
- Offline-first PWA w magazynie. Problemy i sync
Najczęściej zadawane pytania
Co to jest delta sync w kontekście zleceń serwisowych?
Delta sync to przesyłanie tylko zmienionych rekordów od ostatniej synchronizacji, a nie całej bazy danych, co znacznie ogranicza zużycie transferu i czas synchronizacji w terenie.
Jak długo mogą działać zlecenia bez połączenia z siecią?
Zależy to od projektu outboksu i limitu pamięci urządzenia, ale dobrze zaprojektowana kolejka operacji z per‑operation ID i wersjonowaniem wytrzymuje znaczną liczbę operacji offline bez utraty danych.
Czy Background Sync API wystarczy jako jedyny mechanizm synchronizacji?
Nie. Background Sync działa niezawodnie głównie w przeglądarkach opartych na Chromium i bywa throttlowany, więc warto dodać ping do endpointu i przycisk manualnego syncu jako zabezpieczenie.
Jak rozwiązywać konflikty danych między technikiem offline a systemem centralnym?
Dla pól niskiego ryzyka wystarczy reguła last‑write‑wins, ale dla pól decyzyjnych, takich jak koszt czy przypisanie zasobu, potrzebna jest rekoncyliacja przez menedżera na podstawie numeru wersji rekordu.
Czy Synaptix Platform pomaga w integracji kolejki offline z CMMS?
Tak, w ramach pilotażu Synaptix Platform konfiguruje profil offline i integruje kolejkę outbox z istniejącym systemem CMMS lub ERP, testując ją w rzeczywistych warunkach terenowych.