
Dla większości zastosowań IoT z wysoką częstotliwością zapisu najlepszym wyborem jest specjalistyczna baza szeregów czasowych, czyli TSDB. Sprawdza się to zwłaszcza tam, gdzie liczba czujników rośnie, a odczyty napływają co sekundę lub częściej. Decyzję warunkują trzy parametry: przewidywany ingest rate, kontrolowana cardinality serii oraz jasna polityka retencji i downsampling. Jeśli te trzy elementy masz zmapowane, zacznij od pilotażu z realnymi metrykami, zamiast projektować architekturę na papierze.
Krótko mówiąc:
- Najlepszym wyborem dla wysokoczęstotliwościowych danych IoT jest TSDB, zwłaszcza przy dużej liczbie czujników i odczytach co sekundę lub częściej.
- TSDB zapisuje punkty danych tylko w sposób dopisywania, co zwiększa wydajność przy masowych odczytach i eliminuje blokady występujące w bazach relacyjnych.
- Kluczowe jest kontrolowanie kardynalności tagów i planowanie schematu, aby uniknąć nadmiernego rozrostu indeksów i kosztów operacyjnych.
- Projekt schematu powinien uwzględniać rozdzielenie danych na buckety w zależności od skali, z odpowiednią polityką retencji i downsamplingiem.
- Przed wdrożeniem konieczne jest wykonanie testów obciążeniowych, pomiar metryk i zabezpieczenie połączeń, aby uniknąć nieprzewidzianych problemów w produkcji.
Spis treści
- Co to jest TSDB dla IoT i czym różni się od zwykłej bazy danych
- Jak działa TSDB: zapis, indeksy czasu i kompresja
- Projektowanie schematu: tagi, pola, cardinality i bucketing
- Architektura ingest i Edge–Cloud: protokoły i buforowanie
- Przypadki użycia TSDB w IoT: PdM, monitoring, analityka historyczna
- Checklista wdrożeniowa TSDB: metryki, testy i bezpieczeństwo
- Jak Synaptix wykorzystuje TSDB w praktyce przemysłowej
- Migracja do TSDB: na co naprawdę zwrócić uwagę
- Pilotaż TSDB z Synaptix: od czego zacząć
- Źródła
- Najczęściej zadawane pytania
Co to jest TSDB dla IoT i czym różni się od zwykłej bazy danych
TSDB to baza zoptymalizowana pod zapis i odczyt punktów danych powiązanych ze znacznikiem czasu, gdzie każdy punkt ma swoją serię czasową, zestaw tagów opisujących metadane oraz pola z wartościami numerycznymi. Tradycyjna baza relacyjna radzi sobie z tysiącami zapisów na sekundę, ale przy milionach odczytów z czujników zaczyna się dławić na indeksach i blokadach transakcyjnych.
TSDB unika tego problemu, bo z założenia traktuje czas jako oś główną, a nie jeden z wielu atrybutów wiersza. Dzięki temu skaluje się liniowo przy masowych odczytach z czujników przemysłowych, gdzie dane napływają w kolejności chronologicznej i rzadko są modyfikowane po zapisie.
Dobrym przykładem praktycznej implementacji jest format TsFile używany w Apache IoTDB, który przechowuje dane binarnie i udostępnia API do zapisu oraz odczytu zoptymalizowanego pod sekwencyjny dostęp. To pokazuje, że TSDB w IoT nie jest abstrakcyjną koncepcją, a konkretnym formatem plików zaprojektowanym pod ten właśnie ruch danych.
Jak działa TSDB: zapis, indeksy czasu i kompresja
Mechanika TSDB opiera się na zapisach append only, czyli dopisywaniu nowych punktów na końcu struktury bez nadpisywania istniejących wierszy. To fundamentalna różnica względem baz relacyjnych, które muszą sprawdzać unikalność i blokować wiersze przy każdej transakcji.
Ingest w praktyce działa w paczkach, nie pojedynczych rekordach. Batched ingestion pozwala zapisać tysiące punktów jednym wywołaniem, co drastycznie zmniejsza narzut sieciowy i obciążenie procesora po stronie bazy. Wpływa to bezpośrednio na przepustowość: dobrze zaprojektowany pipeline batchowy potrafi obsłużyć rząd wielkości więcej zapisów na sekundę niż ten oparty na pojedynczych insertach.
Indeksowanie w TSDB rozdziela tagi od pól. Tagi są indeksowane, bo służą do filtrowania i grupowania, pola nie, bo są wartościami do agregacji. Ta asymetria ma konsekwencje: zbyt duża liczba unikalnych kombinacji tagów rozrasta indeks i zjada pamięć operacyjną, o czym szerzej w kolejnej sekcji.
Kompresja szeregów czasowych, oparta na algorytmach delta encoding i run-length encoding, bywa kluczowa dla kosztów przechowywania. Prace naukowe nad algorytmami kompresji i indeksowania szeregów czasowych potwierdzają, że dobrze dobrany schemat kompresji może zmniejszyć zajmowaną przestrzeń dyskową wielokrotnie względem surowych danych, bez utraty precyzji odczytu.
Projektowanie schematu: tagi, pola, cardinality i bucketing
Reguła podstawowa brzmi: tagi to metadane, po których filtrujesz i grupujesz, pola to wartości, które mierzysz i agregujesz. Numer seryjny czujnika, lokalizacja, typ urządzenia — to tagi. Temperatura, wibracje, napięcie — to pola.
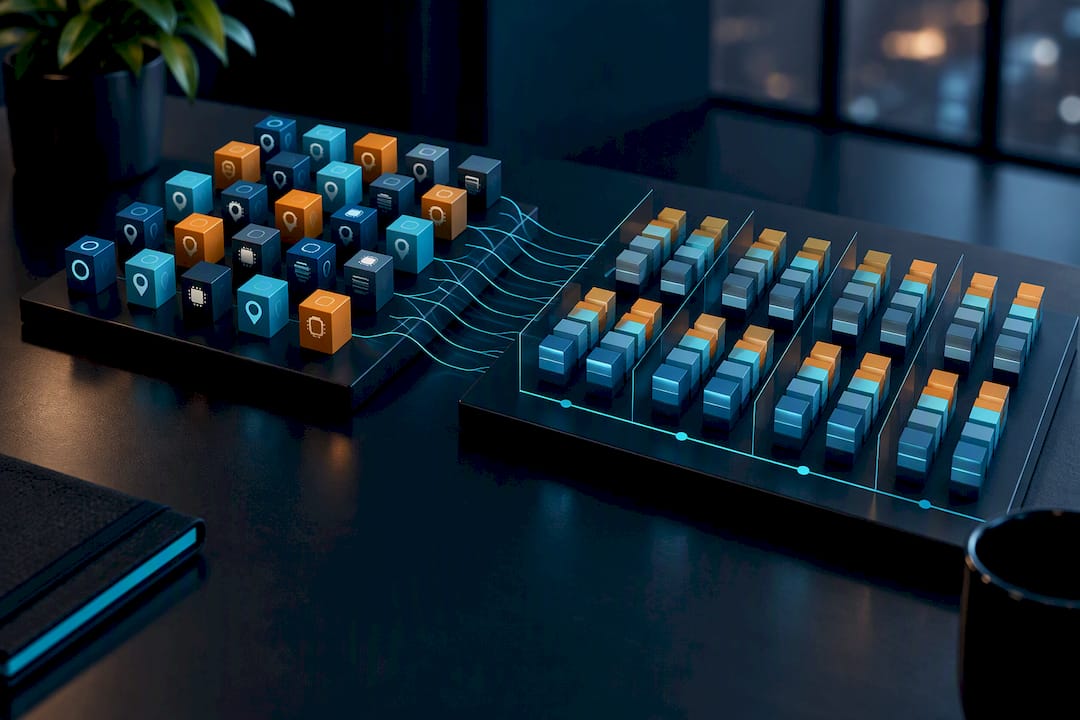
Największym błędem popełnianym przez zespoły wdrażające TSDB w IoT jest traktowanie unikalnych identyfikatorów urządzeń jako tagów o wysokiej kardynalności bez planu retencji. Dokumentacja InfluxData jasno wskazuje, że unikanie identyfikatorów jako tagów oraz kontrola liczby unikalnych kombinacji zapobiega tzw. runaway cardinality, czyli sytuacji, w której indeks rośnie szybciej niż same dane.
Porada profesjonalisty: Zanim zaprojektujesz schemat produkcyjny, policz maksymalną teoretyczną liczbę unikalnych kombinacji tagów. Jeśli przekracza kilkaset tysięcy serii na jedną instalację, rozbij dane na osobne buckety zamiast trzymać wszystko w jednym measurement.
Model bucketów zależy od skali wdrożenia:
- Single bucket — sprawdza się przy jednej linii produkcyjnej lub pilotażu z ograniczoną liczbą czujników.
- Bucket per zakład lub organizacja — separuje dane klientów lub oddziałów, ułatwia retencję różną dla różnych lokalizacji.
- Bucket per typ urządzenia — dobry wybór, gdy różne klasy maszyn wymagają odmiennych polityk down sampling.
Downsampling wprowadzasz w momencie, gdy surowe dane z ostatnich tygodni tracą wartość operacyjną, a analityka historyczna potrzebuje tylko agregatów godzinowych lub dziennych. Poradniki dotyczące projektowania schematu rekomendują ustalenie polityki retencji już na etapie pilotażu, nie po fakcie, gdy koszty przechowywania zaczynają rosnąć nieproporcjonalnie do wartości danych.
Architektura ingest i Edge–Cloud: protokoły i buforowanie
Typowy pipeline danych IoT wygląda tak: urządzenie generuje odczyt, gateway lub węzeł edge go agreguje, kolejka komunikacyjna typu Kafka albo NATS buforuje ruch, a docelowa TSDB w chmurze przyjmuje dane w paczkach. Ten wzorzec, opisywany w analizach infrastruktury IoT, redukuje narzut sieciowy i chroni przed utratą danych przy niestabilnym łączu WAN.
Wybór protokołu transportowego zależy od charakteru urządzeń:
- MQTT dla lekkich czujników bateryjnych, gdzie liczy się minimalny narzut pakietu i odporność na przerywane połączenie.
- OPC‑UA dla środowisk przemysłowych, gdzie potrzebna jest bogata semantyka danych i integracja z systemami SCADA.
- HTTP/REST tam, gdzie urządzenia mają wystarczającą moc obliczeniową i nie ma krytycznych ograniczeń przepustowości.
Porada profesjonalisty: Nigdy nie wysyłaj pojedynczych odczytów bezpośrednio do TSDB w chmurze. Buforuj je na edge w paczkach transakcyjnych z mechanizmem retry, żeby chwilowa utrata łącza nie oznaczała utraty danych z ostatnich minut.
Buforowanie na krawędzi z batchowaniem zmniejsza liczbę połączeń sieciowych i poprawia spójność przesyłu, szczególnie w instalacjach przemysłowych z ograniczoną łącznością komórkową.
Przypadki użycia TSDB w IoT: PdM, monitoring, analityka historyczna
Predykcyjne utrzymanie ruchu wymaga wysokiej częstotliwości próbkowania dla parametrów wibracyjnych i termicznych, retencji surowych danych na tyle długiej, by trenować modele przewidujące awarię, oraz integracji z systemem CMMS do automatycznego generowania zleceń serwisowych.
Monitoring i alertowanie w czasie rzeczywistym stawiają inne wymagania: liczy się opóźnienie zapytania poniżej sekundy i dostępność bazy na poziomie zbliżonym do SLA produkcyjnego, bo alarm spóźniony o minuty traci sens operacyjny.
Analityka długoterminowa, na przykład porównania sezonowe zużycia energii, rzadko wymaga surowych danych sekundowych. Tu sprawdza się downsampling do agregatów godzinowych, a przy bardzo dużych wolumenach historycznych warto rozważyć dodatkową hurtownię danych analityczną obok TSDB operacyjnej.
- PdM: wysoka częstotliwość, długa retencja surowa, integracja z CMMS.
- Monitoring: niska latencja, wysoka dostępność, krótka retencja surowa.
- Analiza historyczna: agregaty, downsampling, ewentualnie osobna hurtownia.
Checklista wdrożeniowa TSDB: metryki, testy i bezpieczeństwo
Przed pilotażem warto zamknąć trzy grupy działań w konkretnych, mierzalnych krokach.
- Metryki bazowe — zmierz ingest na sekundę, opóźnienie zapytań przy typowym obciążeniu, zajętość dysku na serię czasową oraz szczytową cardinality w warunkach produkcyjnych.
- Testy obciążeniowe — przeprowadź symulację peak ingest z realistycznym profilem urządzeń, a osobno test runaway cardinality odtwarzający maksymalną przewidywaną liczbę unikalnych serii, żeby sprawdzić, jak baza reaguje na skok liczby tagów.
- Test retencji i downsamplingu — zweryfikuj, że polityki usuwania starych danych i agregacji faktycznie działają zgodnie z konfiguracją, a nie tylko w dokumentacji.
- Bezpieczeństwo — wymuś TLS lub mTLS na całej trasie od urządzenia do bazy, wprowadź rotację tokenów dostępowych i zaplanuj harmonogram backupów zgodny z polityką retencji.
Ten checklist wykonany przed pełnym wdrożeniem eliminuje większość niespodzianek, które inaczej wychodzą na jaw dopiero po miesiącach produkcji.
Jak Synaptix wykorzystuje TSDB w praktyce przemysłowej
Moduł GridSense w Synaptix Platform korzysta z architektury szeregów czasowych do ciągłego monitorowania stanu maszyn w czasie rzeczywistym, a AutomateFlow automatyzuje przetwarzanie dokumentów serwisowych powstałych na bazie tych odczytów, kierując je do systemów SAP i Maximo.
Synaptix deklaruje, że zastosowanie modeli predykcyjnych opartych na danych czasowych z czujników pozwala ograniczyć nieplanowane przestoje o 30 do 50 procent w pilotażach wdrożeniowych.
Przy planowaniu własnego pilotażu warto od początku mierzyć te same wielkości: częstotliwość odczytów z krytycznych aktywów, opóźnienie między awarią a wygenerowaniem alertu oraz procent zleceń serwisowych utworzonych automatycznie bez interwencji człowieka. Integracja z istniejącym CMMS wymaga zwykle mapowania identyfikatorów aktywów na tagi w schemacie TSDB, co warto zaplanować przed pierwszym zapisem danych produkcyjnych.
Migracja do TSDB: na co naprawdę zwrócić uwagę
Najczęstszy błąd, jaki widzę w planach migracji, to projektowanie architektury docelowej, zanim ktokolwiek zmierzy realny ruch danych. Zacznij od pilota z jasno określonym celem i minimalnym zakresem funkcjonalnym, nie od pełnej platformy.
Zespół potrzebuje trzech kompetencji: integratora znającego protokoły OT, inżyniera DevOps do utrzymania infrastruktury ingest i data engineera do projektowania schematu. Bez tej trójki projekt zwykle grzęźnie na etapie schematu danych.
Własne rozwiązanie edge zamiast prostego przekazywania do chmury ma sens tylko wtedy, gdy skala urządzeń i wymagania latencji przekraczają możliwości łącza WAN, nie wcześniej.
— Mateusz
Pilotaż TSDB z Synaptix: od czego zacząć
Zamiast budować całą architekturę TSDB od zera, możesz zacząć od pilotażu, który mierzy realne parametry na Twoich danych, zanim zainwestujesz w pełną platformę. Synaptix Platform oferuje różne poziomy wdrożenia, różniące się skalą integracji z systemami CMMS oraz ERP.
Pilotaż obejmuje wdrożenie modułu do monitorowania aktywów w czasie rzeczywistym oraz podstawową integrację z wybranymi protokołami przemysłowymi, w zależności od parku maszynowego. Minimalny krok startowy to wskazanie jednej linii produkcyjnej lub grupy krytycznych aktywów i zdefiniowanie metryk sukcesu, na przykład redukcji liczby nieplanowanych przestojów w ciągu pierwszych trzech miesięcy.
Aktualne warunki i zakres poszczególnych planów znajdziesz na stronie cenowej Synaptix, gdzie możesz zgłosić się do pilotażu i ustalić zakres integracji odpowiedni dla Twojej instalacji.
Źródła
Dokumentacja InfluxData opisuje zasady projektowania schematu i unikania szerokich tabel. Apache IoTDB udostępnia dokumentację TsFile oraz opis modelowania hierarchicznego. Praktyczny przegląd architektur znajdziesz w artykule o bazach danych w aplikacjach IoT.
- Data Layout and Schema Design Best Practices for InfluxDB | InfluxData
- TsFile API | IoTDB Website
- Designing Your Schema | Time to Awesome
- Analiza infrastruktury i danych IoT. Wybór bazy
- arXiv preprint
Najczęściej zadawane pytania
Czym różni się TSDB od bazy relacyjnej w IoT?
TSDB traktuje czas jako główną oś danych i zapisuje punkty metodą append only, co eliminuje blokady transakcyjne typowe dla baz relacyjnych. Dzięki temu skaluje się lepiej przy masowym, ciągłym ingest z czujników, gdzie dobre rozgraniczenie tagów i pól często decyduje o wydajności bardziej niż sam wybór silnika.
Jak uniknąć runaway cardinality w schemacie TSDB?
Unikaj używania unikalnych identyfikatorów urządzeń jako tagów i kontroluj liczbę możliwych kombinacji metadanych przed wdrożeniem produkcyjnym. Testy symulujące szczytową liczbę unikalnych serii powinny być standardowym elementem pilotażu, nie opcjonalnym krokiem.
Który protokół wybrać do przesyłu danych z czujników do TSDB?
MQTT sprawdza się przy lekkich czujnikach bateryjnych z ograniczoną łącznością, a OPC‑UA lepiej odwzorowuje semantykę środowisk przemysłowych i integruje się z systemami SCADA. Wybór protokołu wpływa na strukturę bufora na edge i sposób batchowania danych przed zapisem do bazy.
Czy Synaptix Platform wykorzystuje TSDB do monitorowania maszyn?
Moduł GridSense w Synaptix Platform opiera się na architekturze danych szeregów czasowych do ciągłego monitorowania stanu aktywów i wykrywania anomalii. Zakres integracji z konkretnym parkiem maszynowym ustala się indywidualnie na etapie pilotażu, opisanego na stronie cenowej.
Kiedy warto dodać hurtownię danych obok TSDB?
Gdy analityka historyczna wymaga złożonych zapytań łączących dane z wielu systemów biznesowych, a nie tylko agregatów czasowych z czujników. TSDB pozostaje wtedy warstwą operacyjną, a hurtownia obsługuje analizy długoterminowe i raportowanie zarządcze.