
Skuteczna klasyfikacja dokumentów technicznych opiera się na czterech krokach: inwentaryzacja zasobów, digitalizacja ze skanowaniem i OCR, ekstrakcja danych przez modele domenowe (IDP), a na końcu mapowanie pól do CMMS lub ERP. Taki proces daje dostęp do dokumentacji w kilka sekund zamiast minut poszukiwań w segregatorach, poprawia jakość zleceń pracy i tworzy fundament pod predykcyjne utrzymanie ruchu. Pilotaże opisane w blogach na temat OCR dokumentów technicznych i ekstrakcji danych z PDF pokazują, że taki proces da się uruchomić w kilka tygodni, nie miesięcy.
Krótko mówiąc:
- Automatyczne rozpoznanie i klasyfikacja dokumentów technicznych można uruchomić w trzy do pięciu tygodni, skupiając się na kluczowych typach dokumentów i metadanych.
- Kluczowe pola do ekstrakcji obejmują numer rysunku, rewizję, tag PLC oraz numer części, co wymaga zastosowania modeli trenowanych na standardach branżowych.
- Zanim rozpoczniesz, zdefiniuj model danych w systemie CMMS lub ERP i zapewnij odpowiedni hardware, bezpieczeństwo danych oraz właściciela dokumentacji.
- Najczęstsze błędy to brak przygotowania modelu docelowego, zbyt szeroki zakres pilotażu i poleganie na ogólnym OCR, co obniża skuteczność i wydłuża czas wdrożenia.
Spis treści
- Jakie dokumenty techniczne klasyfikować i jakie dane z nich wyciągać
- Skanowanie, OCR i IDP: która technologia do czego
- Mapowanie danych do CMMS i ERP bez bałaganu w danych podstawowych
- Plan pilotażu: zakres, metryki i harmonogram w tygodniach
- Checklist wdrożeniowy: sprzęt, bezpieczeństwo i KPI
- Definicje i kryteria klasyfikacji dokumentów technicznych
- Dlaczego klasyfikacja dokumentów decyduje o efektywności utrzymania ruchu
- Jakie normy regulują dokumentację techniczną
- Przykłady kategorii dokumentów w różnych branżach przemysłu
- Najczęstsze błędy przy klasyfikacji dokumentów technicznych
- Perspektywa autora: praktyczne pułapki i rady z wdrożeń
- Jak Synaptix Platform przyspiesza klasyfikację dokumentów technicznych
- Źródła
- Najczęściej zadawane pytania
Jakie dokumenty techniczne klasyfikować i jakie dane z nich wyciągać
Zakład przemysłowy generuje kilkanaście typów dokumentacji, a każdy wymaga innego zestawu metadanych. Rysunki 2D i 3D potrzebują numeru rysunku, rewizji, daty wydania i skali. Schematy elektryczne wymagają tagów PLC, numerów zacisków i oznaczeń obwodów. Karty katalogowe i instrukcje serwisowe niosą numery części, parametry nominalne oraz zakresy tolerancji.
Do tego dochodzą protokoły przeglądów, listy części zamiennych, dokumentacja techniczno-ruchowa (DTR), analizy HAZOP oraz certyfikaty materiałowe (mill certificates) potwierdzające skład i pochodzenie surowca.
Priorytetowe pola do ekstrakcji wyglądają następująco:
- Rysunki techniczne – numer rysunku, numer rewizji, data, skala, oznaczenie projektanta.
- Schematy elektryczne – tag PLC, numer zacisku, napięcie znamionowe, oznaczenie obwodu.
- Karty katalogowe – numer części, producent, parametry nominalne, tolerancje.
- DTR i protokoły przeglądów – numer urządzenia, data przeglądu, wynik, osoba odpowiedzialna.
- Certyfikaty materiałowe – numer partii, skład chemiczny, norma odniesienia.
Rysunki wielkoformatowe (A0, A1) wymagają skanerów przelotowych o odpowiedniej rozdzielczości, a nie zwykłych podajników biurowych. Bez inwentaryzacji zasobów przed digitalizacją łatwo pominąć rysunki zwinięte w tubach albo naklejone na maszynach, które nigdy nie trafiły do żadnego archiwum cyfrowego.
Skanowanie, OCR i IDP: która technologia do czego
Sam OCR rozpoznaje tekst na obrazie. To za mało dla dokumentu technicznego, w którym liczy się struktura: który numer części odnosi się do którego komponentu na rysunku, który tag PLC pasuje do którego obwodu. Dlatego proces przetwarzania dokumentów technicznych ma pięć etapów: kontrola jakości pliku wejściowego, OCR, analiza układu strony (layout parsing), wyodrębnienie pól i normalizacja wartości do jednego formatu.
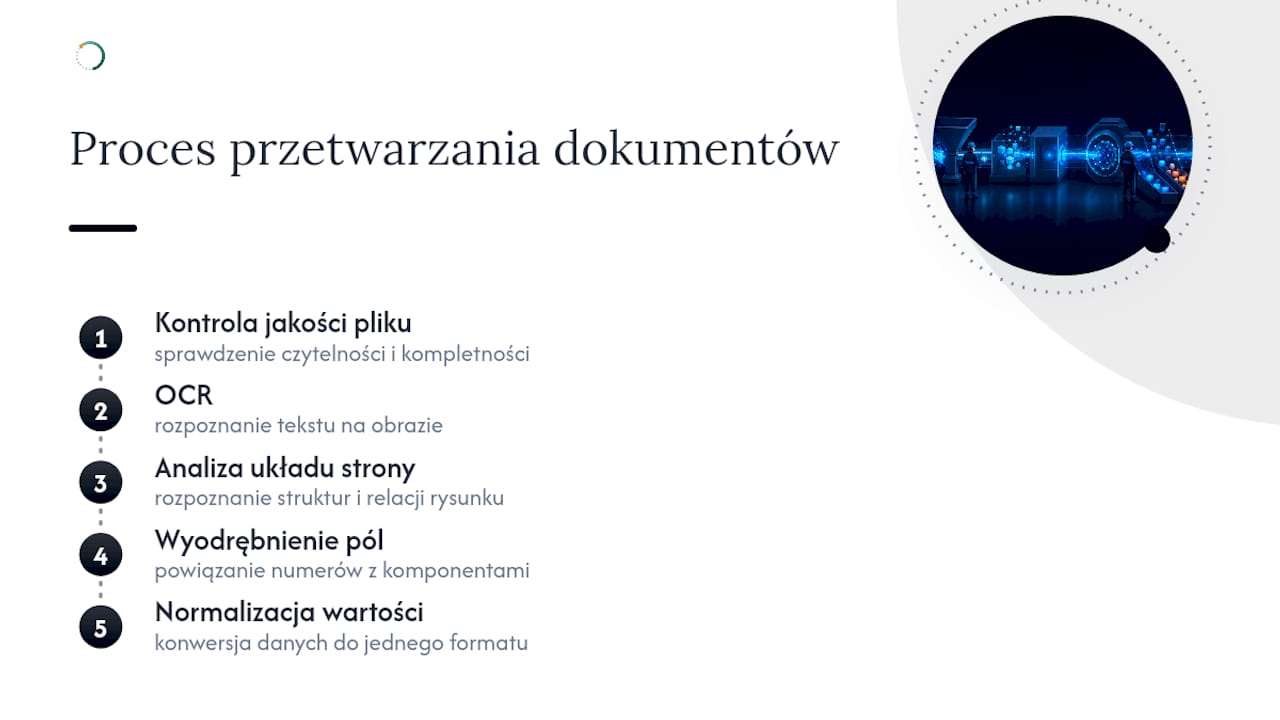
Różnica między ogólnym modelem językowym a inteligentnym przetwarzaniem dokumentów (IDP) trenowanym na symbolice inżynierskiej jest praktyczna, nie akademicka. Ogólny model potrafi przeczytać tekst, ale myli symbol zaworu z symbolem pompy na schemacie P&ID. Inteligencja dokumentów inżynierskich rozpoznaje strukturę rysunku i przekazuje dane bezpośrednio do SAP PM lub IBM Maximo z dokładnością na poziomie pola, nie tylko strony.
Eksperci rekomendują trenowanie modeli na normach symboliki, takich jak ISA-5.1, zamiast liczyć na uniwersalne rozpoznawanie obrazu. Dla rysunków P&ID wektoryzacja i rozpoznawanie topologii są konieczne, bo relacje między symbolami niosą więcej informacji niż sam tekst na etykietach.
Kwestia przetwarzania offline versus w chmurze decyduje często o akceptacji projektu przez dział IT. Rysunki maszyn czy schematy linii produkcyjnych bywają objęte klauzulami poufności z kontraktów z dostawcami, więc przetwarzanie lokalne na serwerze zakładowym bywa jedynym akceptowalnym rozwiązaniem.
Porada profesjonalisty: Zanim wybierzesz dostawcę IDP, poproś o wynik testu na własnych, prawdziwych rysunkach P&ID z Twojego zakładu, nie na demówce dostawcy. Symbolika różni się między branżami i rocznikami norm, a model wytrenowany na przykładach z innej instalacji potrafi mylić się w zaskakujący sposób.
Mapowanie danych do CMMS i ERP bez bałaganu w danych podstawowych
Największy błąd we wdrożeniach klasyfikacji dokumentów to rozpoczęcie ekstrakcji przed zdefiniowaniem modelu docelowego. Zespół wyciąga dziesiątki pól z dokumentu, a potem odkrywa, że SAP PM albo IBM Maximo mają zupełnie inną strukturę pól i część danych nie ma gdzie trafić.
Poprawna kolejność wygląda tak:
- Zdefiniuj model docelowy w CMMS/ERP – ustal, jakie pola faktycznie istnieją w Twoim systemie (np.
drawing_number,revision,equipment_tag) zanim zaczniesz ekstrakcję. - Zaprojektuj transformację jeden do jednego – wyodrębniony numer rysunku trafia w pole
drawing_number, numer rewizji w polerevision, tag urządzenia wequipment_tag. - Zastosuj weryfikację krzyżową między dokumentami – porównaj numer części z karty katalogowej z listą części z DTR, a tag PLC ze schematu ze schematem instalacji, zanim dane trafią do bazy.
- Zapisz metadane audytowe – kto zatwierdził rekord, kiedy, na podstawie jakiej wersji dokumentu źródłowego.
- Włącz kontrolę wersji – każda nowa rewizja rysunku aktualizuje pole
revision, a stara wersja zostaje oznaczona jako archiwalna, nie usunięta.
Mapowanie pól na etapie planowania integracji, a nie po fakcie, chroni przed zanieczyszczeniem danych podstawowych. Wysyłanie „wszystkich” pól bez filtra kończy się zduplikowanymi rekordami i sprzecznymi wartościami w tym samym polu equipment_tag. Pięciowarstwowa weryfikacja krzyżowa brzmi jak nadmiar procedury, dopóki nie zobaczysz zlecenia pracy wygenerowanego na błędnym numerze części.
Plan pilotażu: zakres, metryki i harmonogram w tygodniach
Pilotaż klasyfikacji dokumentów technicznych ma sens tylko wtedy, gdy jest wąski i mierzalny. Rozsądny zakres to jedna lub dwie krytyczne linie produkcyjne i jeden lub dwa typy dokumentów, na przykład schematy elektryczne i karty katalogowe. Szerszy zakres na starcie rozmywa odpowiedzialność i wydłuża czas do pierwszych wniosków.
Metryki sukcesu, które warto ustalić przed startem:
- SLA dokładności pola – jaki procent wyodrębnionych pól jest poprawny bez korekty manualnej.
- Procent automatycznej klasyfikacji – ile dokumentów trafia do właściwej kategorii bez interwencji człowieka.
- Czas od skanu do dostępności w CMMS – liczony w minutach, nie dniach.
- Redukcja godzin pracy manualnej – porównanie z poprzednim procesem ręcznego wprowadzania danych.
Przykładowy harmonogram na 12 tygodni: tygodnie 0 do 2 to inwentaryzacja dokumentów i wybór linii pilotażowej, tygodnie 3 do 5 to digitalizacja i konfiguracja OCR, tygodnie 6 do 9 to trening modelu domenowego i pierwsze testy ekstrakcji, tygodnie 10 do 12 to integracja z CMMS i pomiar metryk końcowych. Case study z wdrożenia u Prometheus Group pokazuje, jak wygląda skok jakości: automatyzacja odczytu dokumentów podniosła dokładność danych z około 50% przy pracy manualnej do 84%, przy wyniku F1 na poziomie 96% dla samego modelu ekstrakcji.
Decyzję o skalowaniu na cały zakład warto podejmować dopiero, gdy pilotaż osiągnie zakładany SLA dokładności przez co najmniej dwa kolejne cykle pomiarowe, nie po jednym udanym teście.
Checklist wdrożeniowy: sprzęt, bezpieczeństwo i KPI
Zanim uruchomisz pilotaż, sprawdź te elementy jeden po drugim:
- Sprzęt – skaner wielkoformatowy do rysunków A0/A1, serwer edge do lokalnego przetwarzania, stabilna sieć w hali produkcyjnej.
- Backup – automatyczna kopia zapasowa zeskanowanych dokumentów przed rozpoczęciem ekstrakcji.
- Model bezpieczeństwa – wybór między przetwarzaniem on-premise a chmurą, zależnie od klauzul poufności z dostawcami maszyn.
- Szyfrowanie i RBAC – kontrola dostępu oparta na rolach, żeby technik terenowy widział inne dane niż inżynier procesu.
- Retencja danych – jasna polityka, jak długo przechowywać wersje archiwalne dokumentów.
- Właściciel dokumentacji – jedna osoba lub zespół odpowiedzialny za aktualizację rysunków as-built po każdej modyfikacji instalacji.
Rekomendowane KPI operacyjne to czas dostępności dokumentu od zgłoszenia, SLA ekstrakcji pola oraz procent rekordów wymagających manualnej korekty po wdrożeniu produkcyjnym.
Porada profesjonalisty: Wyznacz właściciela dokumentacji zanim uruchomisz pilotaż, nie po nim. Bez jednej osoby odpowiedzialnej za aktualizację rysunków as-built system po pół roku znów zacznie się rozjeżdżać z rzeczywistością instalacji, niezależnie od tego, jak dobry był model ekstrakcji na starcie.
Definicje i kryteria klasyfikacji dokumentów technicznych
Klasyfikacja dokumentów technicznych w kontekście utrzymania ruchu oznacza przypisanie dokumentu do kategorii na podstawie jego funkcji operacyjnej, a nie wyłącznie formatu pliku. Kryteria klasyfikacji obejmują typ dokumentu (rysunek, schemat, protokół), powiązane urządzenie lub linię produkcyjną, etap cyklu życia aktywa (projekt, eksploatacja, przegląd) oraz poziom poufności.
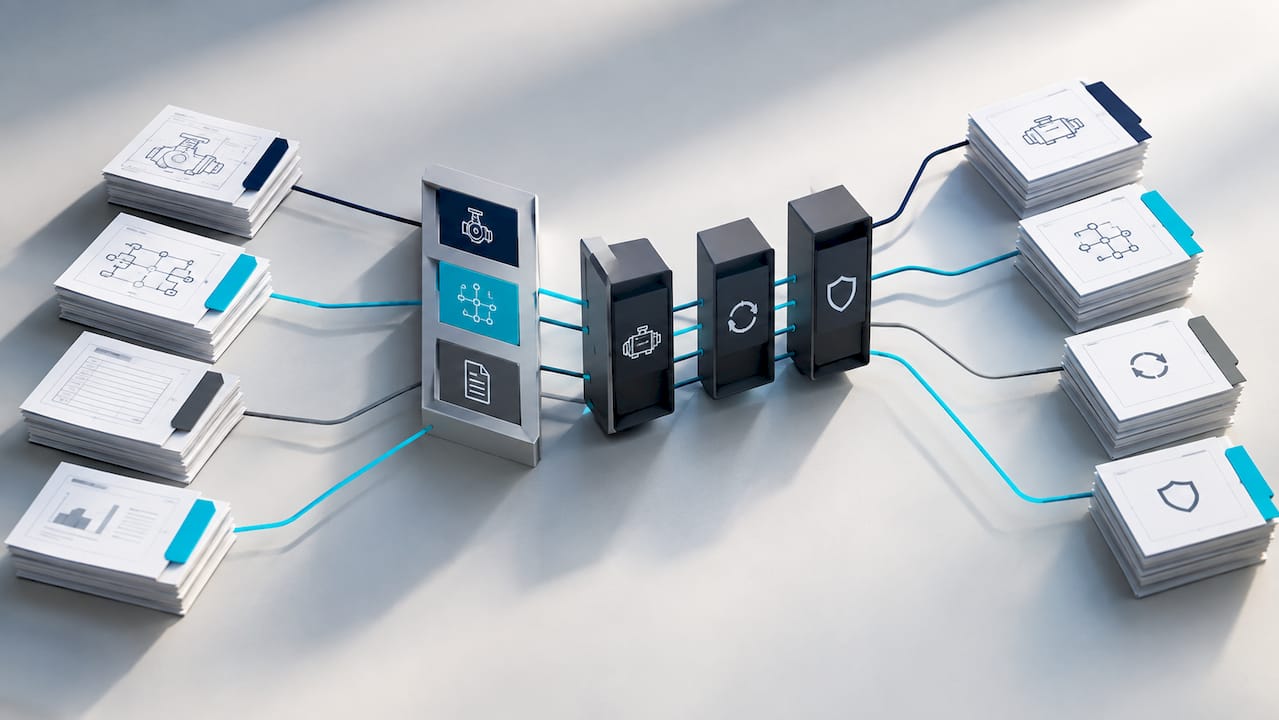
Dobra klasyfikacja odpowiada na trzy pytania: czego dotyczy dokument, kiedy powstał i jaka jest jego aktualna rewizja. Bez tych trzech elementów system CMMS traktuje każdy plik jako izolowany rekord, zamiast łączyć go z historią konkretnego urządzenia.
Kryteria techniczne różnią się od kryteriów archiwalnych stosowanych w dokumentacji korporacyjnej czy prawnej. W utrzymaniu ruchu klasyfikacja musi wspierać wyszukiwanie w czasie awarii, kiedy technik ma minuty, nie godziny, na znalezienie właściwego schematu. Dlatego kategoria dokumentu łączy się bezpośrednio z tagiem urządzenia w CMMS, a nie z numerem teczki archiwalnej.
Praktyczny test dobrej klasyfikacji: czy technik na hali, wpisując numer maszyny w aplikacji mobilnej, dostaje właściwy rysunek, właściwą rewizję i właściwy protokół ostatniego przeglądu w jednym miejscu. Jeśli odpowiedź brzmi nie, kryteria klasyfikacji wymagają korekty, niezależnie od tego, jak zaawansowana jest technologia OCR stojąca za systemem.
Dlaczego klasyfikacja dokumentów decyduje o efektywności utrzymania ruchu
Uporządkowana dokumentacja skraca czas naprawy, bo technik nie traci czasu na szukanie właściwego schematu w segregatorze albo w chaotycznym folderze sieciowym. Praktyka pokazuje, że nieuporządkowana dokumentacja bywa głównym wąskim gardłem przy awariach, nawet gdy zakład dysponuje nowoczesnymi czujnikami i systemami monitoringu.
Dane z czujników IoT bez kontekstu dokumentacji tracą znaczną część wartości. Odczyt wibracji z łożyska nic nie mówi technikowi, jeśli nie ma dostępu do karty katalogowej z dopuszczalnymi parametrami i historii poprzednich przeglądów tego konkretnego urządzenia. Dashboardy z danymi w czasie rzeczywistym stają się użyteczne dopiero wtedy, gdy każdy punkt danych da się połączyć z właściwym dokumentem referencyjnym.
Klasyfikacja dokumentów wpływa też bezpośrednio na budowę cyfrowego bliźniaka (digital twin) instalacji. Poprawna struktura i kategoryzacja dokumentacji to warunek konieczny dla powiązania danych maszynowych z modelem predykcyjnym, bo model predykcyjny musi wiedzieć, które parametry są normalne dla konkretnego typu urządzenia z konkretnej karty katalogowej.
Efekt kaskadowy jest wymierny: krótszy czas przestoju, mniej błędnych decyzji serwisowych opartych na nieaktualnej rewizji rysunku i szybsze wdrażanie nowych techników, którzy nie muszą uczyć się, gdzie leżą papierowe archiwa poprzednika.
Jakie normy regulują dokumentację techniczną
Symbolika stosowana na schematach instrumentacji i automatyki podlega normie ISA-5.1, która definiuje oznaczenia zaworów, czujników i pętli sterowania. To standard, na którym warto opierać trening modeli do automatycznej ekstrakcji danych z rysunków P&ID, bo bez wspólnego słownika symboli model uczy się rozpoznawać wzorce właściwe tylko dla jednego zakładu.
Poza symboliką instrumentacyjną liczą się normy rysunku technicznego (oznaczenia wymiarowe, skale, formaty arkuszy) oraz wewnętrzne standardy nazewnictwa dokumentów, które firmy przemysłowe zwykle definiują same, dostosowując je do struktury swojego CMMS. Certyfikaty materiałowe podlegają z kolei normom jakościowym właściwym dla branży, na przykład normom hutniczym dotyczącym składu chemicznego stali.
Znaczenie norm dla klasyfikacji dokumentów technicznych jest praktyczne: gdy model rozpoznawania jest trenowany zgodnie z uznanym standardem symboliki, łatwiej przenieść go między zakładami tej samej grupy kapitałowej albo między liniami produkcyjnymi. Firmy, które ignorują normy i budują własną, niespójną symbolikę rysunków, płacą za to później wyższym kosztem trenowania modeli i częstszymi błędami ekstrakcji.
Warto też pamiętać o normach dotyczących audytów jakości i łańcucha dostaw, szczególnie w przemyśle ciężkim, gdzie zestawianie dokumentacji dostawcy z wymogami normy ISO 9001 wymaga automatycznego porównywania certyfikatów materiałowych z zamówieniami zakupowymi.
Przykłady kategorii dokumentów w różnych branżach przemysłu
Kategorie dokumentów technicznych różnią się w zależności od branży, choć logika klasyfikacji pozostaje podobna. W energetyce i sektorze użyteczności publicznej dominują schematy jednokreskowe sieci, protokoły przeglądów transformatorów oraz dokumentacja zgodności z normami bezpieczeństwa elektrycznego.
W przemyśle motoryzacyjnym najczęściej klasyfikowane są rysunki komponentów, specyfikacje materiałowe oraz dokumentacja procesowa linii montażowych, często objęta ścisłą poufnością wobec dostawców pierwszego poziomu (Tier 1). W takich przypadkach przetwarzanie w pełni offline na serwerach klienta bywa wymogiem kontraktowym, nie tylko preferencją IT.
Przemysł chemiczny i petrochemiczny opiera się przede wszystkim na schematach P&ID, analizach HAZOP i kartach bezpieczeństwa substancji (SDS), gdzie precyzja klasyfikacji ma bezpośrednie znaczenie dla bezpieczeństwa procesowego. Sektor spożywczy klasyfikuje głównie dokumentację higieniczną, protokoły czyszczenia instalacji (CIP) oraz certyfikaty zgodności z normami jakości żywności.
Firmy zajmujące się elektroplanowaniem i projektowaniem instalacji elektrycznych mają dodatkową specyfikę: rysunki elektryczne wymagają odrębnej wektoryzacji od rysunków mechanicznych, bo symbolika i relacje topologiczne rządzą się innymi regułami.
Wspólny mianownik dla wszystkich branż: im bardziej regulowany i bezpieczeństwo-krytyczny sektor, tym mniejsza tolerancja na błędy klasyfikacji i tym większa wartość modeli domenowych zamiast ogólnych narzędzi OCR.
Najczęstsze błędy przy klasyfikacji dokumentów technicznych
Pierwszy i najkosztowniejszy błąd to rozpoczęcie digitalizacji bez zdefiniowania modelu docelowego w CMMS albo ERP. Zespół skanuje setki dokumentów, wyciąga dziesiątki pól, a potem odkrywa, że system docelowy przyjmuje tylko część z nich w zupełnie innym formacie.
Drugi błąd to zbyt szeroki zakres pilotażu. Próba klasyfikacji wszystkich typów dokumentów na wszystkich liniach naraz rozmywa metryki sukcesu i utrudnia znalezienie źródła problemu, gdy dokładność ekstrakcji spada poniżej oczekiwań.
Trzeci błąd to poleganie na ogólnym modelu OCR tam, gdzie potrzebny jest model domenowy trenowany na symbolice inżynierskiej. Ogólny model radzi sobie z tekstem, ale gubi się w relacjach topologicznych na schemacie P&ID, co prowadzi do błędnych powiązań między symbolami.
Czwarty błąd to ignorowanie kwestii bezpieczeństwa danych na etapie planowania, a nie po fakcie. Firmy, które najpierw wybierają narzędzie chmurowe, a dopiero potem konsultują się z działem bezpieczeństwa, często muszą wracać do punktu wyjścia, gdy okazuje się, że rysunki objęte są klauzulą poufności z kontraktu z dostawcą.
Piąty, często niedoceniany błąd to brak procesu aktualizacji dokumentacji as-built po wdrożeniu. System klasyfikuje dokumenty poprawnie w dniu uruchomienia, ale bez wbudowanego kroku aktualizacji w cyklu pracy CMMS dane zaczynają się rozjeżdżać z rzeczywistością instalacji już po kilku miesiącach.
Perspektywa autora: praktyczne pułapki i rady z wdrożeń
Najczęstsza pułapka, jaką widzę we wdrożeniach klasyfikacji dokumentów, to odwrócona kolejność pracy: zespoły zaczynają od pytania „jak wyciągnąć dane z rysunku”, zamiast od pytania „jakie pole w Maximo w ogóle istnieje na te dane”. Drugi błąd to traktowanie bezpieczeństwa jako dodatku na koniec projektu, a nie warunku startowego, szczególnie tam, gdzie rysunki objęte są poufnością kontraktową.
Moja rada jest prosta: zaczynaj mało, iteruj szybko i wymagaj twardych dowodów walidacji na każdym etapie, nie tylko demówki na koniec pilotażu. Przypisz jedną osobę jako właściciela dokumentacji, zanim jeszcze uruchomisz skaner. Case studies takie jak pilotaż OCR opisany w blogu czy proces ekstrakcji danych z PDF pokazują, że wąski, dobrze zmierzony pilotaż w kilka tygodni daje więcej wiarygodnych danych do decyzji o skalowaniu niż sześciomiesięczny projekt bez jasnych metryk.
— Mateusz
Jak Synaptix Platform przyspiesza klasyfikację dokumentów technicznych
Zamiast budować pipeline klasyfikacji od zera, wdrażasz gotowy moduł: AutomateFlow automatyzuje przetwarzanie dokumentów przez OCR, przetwarzanie języka naturalnego i routing bezpośrednio do SAP lub Maximo, a GridSense monitoruje aktywa w czasie rzeczywistym, łącząc dane z czujników z dokumentacją techniczną tego samego urządzenia.
Podejście oparte na architekturze mikroserwisów i event sourcingu pozwala dopasować model ekstrakcji do konkretnego typu maszyny w Twoim zakładzie, zamiast korzystać z jednego uniwersalnego modelu dla wszystkich klientów. Dowody wykonalności takiego podejścia widać w opisanych wcześniej pilotażach OCR i ekstrakcji danych z PDF, gdzie proces od skanu do dostępności w CMMS trwał tygodnie, nie kwartały.
Sprawdź szczegóły planów Pilot, Platform i Enterprise na stronie z cennikiem i umów rozmowę o zakresie własnego pilotażu, dopasowanego do Twoich krytycznych linii produkcyjnych.
Źródła
- Engineering Document Intelligence: AI That Reads P&IDs & Specs
- Jak wdrożyć digitalizację dokumentacji technicznej?
Najczęściej zadawane pytania
Czym jest klasyfikacja dokumentów technicznych?
To proces przypisywania dokumentów takich jak rysunki, schematy czy protokoły przeglądów do kategorii operacyjnych na podstawie ich funkcji, powiązanego urządzenia i etapu cyklu życia, tak by system CMMS mógł je automatycznie odnaleźć i wykorzystać.
Ile trwa pilotaż klasyfikacji dokumentów?
Dobrze zaprojektowany pilotaż na jednej lub dwóch liniach produkcyjnych trwa zwykle około 12 tygodni, od inwentaryzacji dokumentów po pełną integrację z CMMS i pomiar metryk końcowych.
Czym różni się OCR od inteligentnego przetwarzania dokumentów?
OCR rozpoznaje sam tekst na obrazie, natomiast inteligentne przetwarzanie dokumentów (IDP) rozumie strukturę rysunku, relacje między symbolami i przekazuje gotowe dane bezpośrednio do pól w SAP PM lub IBM Maximo.
Czy dokumenty techniczne trzeba przetwarzać w chmurze?
Nie zawsze. Zakłady z klauzulami poufności wobec dostawców maszyn często wybierają przetwarzanie w pełni offline na serwerze lokalnym, żeby rysunki i schematy nigdy nie opuszczały sieci zakładowej.
Ile kosztuje wdrożenie platformy Synaptix do klasyfikacji dokumentów?
Ceny planów Pilot, Platform i Enterprise są dostępne po kontakcie na stronie z cennikiem Synaptix Platform, gdzie koszt zależy od liczby modułów i skali integracji z CMMS lub ERP.