
Modelowanie danych maszynowych oznacza budowę modeli detekcji anomalii, fault precognition i przewidywania resztkowej żywotności (RUL) na danych z czujników. Zacznij od 3–5 krytycznych aktywów, zbieraj sygnały minimum 3 miesiące, trenuj najpierw detekcję anomalii, potem dopiero RUL, i od pierwszego dnia integruj alerty z systemem CMMS jako zlecenia pracy. Bez tego ostatniego kroku projekt zostaje ładnym washboardem, którego nikt nie używa.
Krótko mówiąc:
- Wdrożenie modelowania danych maszynowych wymaga zbierania minimum 3 miesięcy sygnałów z czujników, lecz prognozowanie RUL potrzebuje zwykle 12 miesięcy danych.
- Kluczowe jest zastosowanie wspólnego schematu opisu urządzeń oraz warstwy integracyjnej typu Unified Namespace, aby zapewnić skalowalność i wysoką dokładność modeli.
- Metody detekcji awarii, takie jak Autoenkodery czy modele nadzorowane, mają różne zastosowania w zależności od dostępności etykiet i sekwencji degradacji.
- Pilotaż skutecznie prowadzony obejmuje wybór aktywów, audyt danych, budowę profili „zdrowych” maszyn i integrację z systemami CMMS, a jego sukces mierzy się redukcją nieplanowanych przestojów.
- Automatyzacja alertów i ich integracja z systemami zarządzania pracą jest kluczowa dla skutecznego wdrożenia PdM i uniknięcia porażek wynikających z braku reakcji na prognozy.
Spis treści
- Wymagania danych i architektura: canonical asset model i Unified Namespace
- Detekcja anomalii, fault precognition i RUL: którą metodę wybrać
- Plan pilotażu: od wyboru aktywów do integracji z CMMS
- MLOps w utrzymaniu ruchu: dryf, retraining i tryb shadow
- Najczęstsze błędy przy wdrażaniu modeli predykcyjnych
- Perspektywa autora: kiedy kupić platformę, a kiedy budować samodzielnie
- Synaptix Platform: jak przejść od pilotażu do skalowania
- Źródła
- Najczęściej zadawane pytania
Wymagania danych i architektura: canonical asset model i Unified Namespace
Zanim ktokolwiek w twoim zespole napisze pierwszą linię kodu modelu, musisz odpowiedzieć na jedno pytanie: skąd wiadomo, że dane z czujnika A na maszynie w hali 3 znaczą to samo co dane z czujnika A na identycznej maszynie w hali 7? Bez odpowiedzi żaden model nie generalizuje.
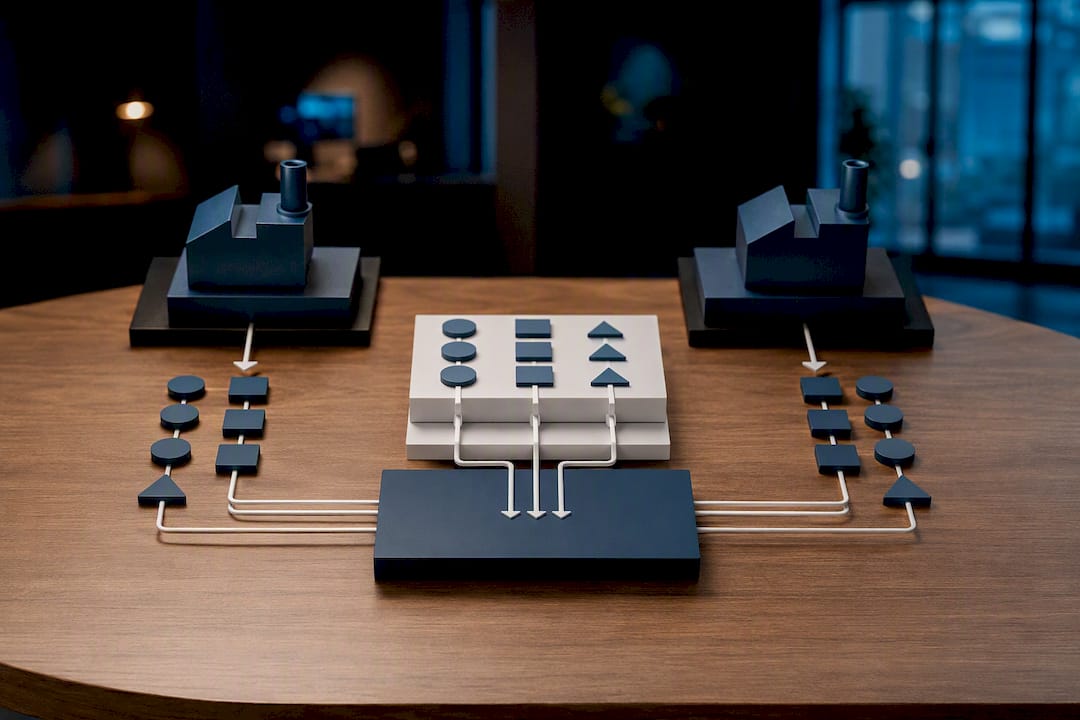
Rozwiązaniem jest canonical asset model — jeden, wspólny schemat opisu każdego urządzenia, niezależny od tego, czy dane pochodzą z PL, SCADA czy starego czujnika analogowego. Warstwa integracyjna typu Unified Namespace (UNS) w połączeniu z protokołem OPC‑UA porządkuje ten chaos jeszcze przed etapem modelowania. Test‑bench opisany w badaniu nad architekturą UNS dla przemysłu pokazał, że taka warstwa podniosła dokładność modeli predykcyjnych do ponad 90% i zredukowała opóźnienia do poziomu poniżej 20 milisekund.
Praktyczna architektura ma trzy poziomy:
- Warstwa surowa (raw ingestion) — dane z czujników bez żadnej obróbki, ze znacznikiem czasu i identyfikatorem źródła.
- Warstwa kanoniczna (curated layer) — dane znormalizowane do jednostek SI, zsynchronizowane w czasie, przypisane do konkretnego aktywa w modelu kanonicznym.
- Warstwa decyzyjna — wyniki modeli, progi alertów, powiązanie z historią zleceń serwisowych.
Minimalny horyzont zbierania danych zależy od celu: 3 miesiące starczają na wstępną detekcję anomalii, ale prognozowanie RUL wymaga zwykle 12 miesięcy historii, żeby model zobaczył pełny cykl degradacji przynajmniej raz.
Porada profesjonalisty: Zanim zaczniesz trenować cokolwiek, sprawdź synchronizację czasu między źródłami. Rozjazd kilku sekund między czujnikiem wibracji a systemem SCADA potrafi całkowicie zepsuć etykietowanie zdarzeń awaryjnych.
Detekcja anomalii, fault precognition i RUL: którą metodę wybrać
Wybór metody zależy od tego, ile masz oznakowanych awarii w historii i jak krytyczna jest maszyna. Trzy podejścia rządzą tym obszarem, każde z innym profilem ryzyka:
- Isolation Forest — szybki, lekki, dobry punkt startowy, gdy masz mało danych i zero etykiet awarii.
- Autoenkodery — lepsze przy danych sekwencyjnych z wielu czujników; błąd rekonstrukcji (recon‑loss) rośnie wyraźnie przed samą awarią, co pozwala wychwycić moment startu degradacji, zanim model RUL zdąży ją policzyć.
- Modele nadzorowane (supervised) — mają sens tylko wtedy, gdy masz wystarczająco dużo historycznych przypadków awarii z pewnymi etykietami; w praktyce przemysłowej to rzadkość.
Badania nad podejściem łączącym niezdolne wykrywanie anomalii z modelami głębokimi pokazują, że segmentacja fazy degradacji przed treningiem modelu RUL zwiększa trafność prognoz, zwłaszcza przy ograniczonej liczbie etykiet.
Statystyka, która zmienia podejście do preprocessingu: zastosowanie filtrów wygładzających sygnał, takich jak Savitzky‑Golay czy filtr Kalmana, w połączeniu ze wskaźnikiem degradacji (Degradation Index) podniosło współczynnik R² prognoz RUL do zakresu 0,70–0,90 nawet przy zaszumionej telemetrii — czyli w warunkach, które w przemyśle są normą, nie wyjątkiem.
Przy ograniczonych etykietach i różnych typach maszyn transfer learning i dual‑LSTM pozwalają przenieść wiedzę z jednego typu aktywa na inny, co skraca czas dojścia do użytecznego modelu RUL o miesiące względem budowy od zera.
Plan pilotażu: od wyboru aktywów do integracji z CMMS
Dobry pilotaż PdM ma jasny harmonogram i kryteria wyjścia, nie tylko wejścia. Oto sekwencja, która sprawdza się w praktyce:
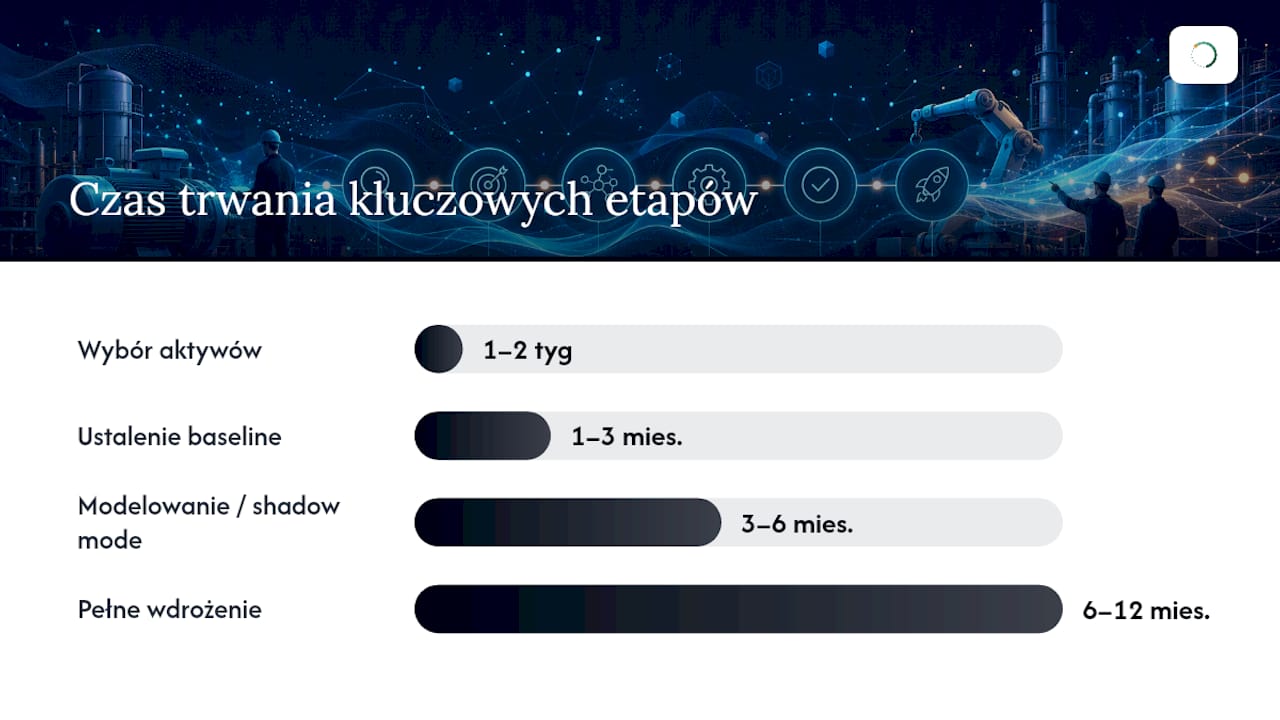
- Wybór aktywów (tydzień 1–2) — 3–5 maszyn o najwyższym koszcie nieplanowanego przestoju, nie te najłatwiejsze do zinstrumentowania.
- Audyt danych (tydzień 2–4) — sprawdzenie kompletności sygnałów, historii zleceń serwisowych, dostępności etykiet awarii.
- Ustalenie baseline (miesiąc 1–3) — zbieranie danych w warunkach normalnej pracy, budowa profilu „zdrowej” maszyny.
- Modelowanie i shadow mode (miesiąc 3–6) — model działa równolegle z istniejącym monitoringiem, generuje alerty bez ich wysyłania do techników.
- Integracja z CMMS (miesiąc 5–7) — alert automatycznie tworzy zlecenie w systemie utrzymania ruchu (np. integracja z IBM Maximo).
- Pełne wdrożenie (miesiąc 6–12) — alerty trafiają do techników w czasie rzeczywistym, mierzysz efekt na produkcji.
Metryki sukcesu pilota to: redukcja nieplanowanego przestoju, spadek średniego czasu naprawy (MTTR), precyzja i recall detekcji anomalii, oraz odsetek alertów przekształconych automatycznie w zlecenie pracy bez ręcznej interwencji planisty.
Do zespołu potrzebujesz minimum czterech ról: inżyniera danych, inżyniera rzetelności (reliability engineer), planisty utrzymania ruchu i menedżera projektu koordynującego harmonogram. Praktyczne przewodniki implementacyjne wskazują, że pierwsze zauważalne efekty przychodzą po kilku miesiącach, a pełne modele RUL dojrzewają zwykle w ciągu około roku lub dłużej. (https://ecosire.com/blog/predictive-maintenance-implementation).
Porada profesjonalisty: Nie mierz sukcesu pilota liczbą wygenerowanych alertów. Mierz go liczbą alertów, które faktycznie zamieniły się w zaplanowaną, a nie awaryjną, naprawę.
MLOps w utrzymaniu ruchu: dryf, retraining i tryb shadow
Model, który działał świetnie w miesiącu pierwszym, może zawodzić w miesiącu dziesiątym. Maszyny się starzeją, warunki pracy się zmieniają, a rozkład danych wejściowych „dryfuje” od tego, na czym model był trenowany.
- Monitoruj dryf danych porównując rozkład sygnałów produkcyjnych z rozkładem ze zbioru treningowego co tydzień, nie co kwartał.
- Ustaw wskaźniki wyzwalające retraining automatycznie, gdy precyzja modelu spada poniżej ustalonego progu.
- Każdą nową wersję modelu testuj w shadow mode, zanim jej alerty trafią do techników na produkcji.
- Zachowaj ścieżkę rollback do poprzedniej, stabilnej wersji modelu i prosty monitoring oparty na regułach jako siatkę bezpieczeństwa.
- Zasilaj retraining danymi z zamkniętych zleceń serwisowych — to jedyny sposób, by model uczył się na rzeczywistych, potwierdzonych awariach.
Firmy, które chcą utrzymać wiarygodność modeli w skali, muszą rozwiązać właśnie te wyzwania operacyjne. Analiza McKinsey podkreśla, że integracja alertów predykcyjnych z systemem zarządzania pracą jest warunkiem, by insighty modelu faktycznie przekładały się na działanie, a nie ginęły w kolejnym raporcie.
Najczęstsze błędy przy wdrażaniu modeli predykcyjnych
Największym zabójcą projektów PdM nie jest słaby model. Jest nim brak wymuszonego działania na jego wynikach.
- Nie zostawiaj alertów tylko na dashboardzie — każdy alert o określonym poziomie ryzyka musi automatycznie generować zlecenie pracy.
- Ustal jasny próg decyzyjny dla techników: co robić przy alercie niskiego, a co przy wysokiego priorytetu, zanim zmęczenie alarmami zniweczy zaufanie do systemu.
- Rozwiąż fragmentację źródeł danych (PLC, SCADA, arkusze techników) przez model kanoniczny, zanim zaczniesz trenować cokolwiek.
- Zaangażuj planistów i techników od pierwszego dnia pilotażu, nie na etapie wdrożenia produkcyjnego.
Porada profesjonalisty: Jeśli technik dostanie trzy fałszywe alarmy w pierwszym tygodniu, przestanie ufać systemowi na kolejne dwa lata, niezależnie od tego, jak dobry stanie się model.
Perspektywa autora: kiedy kupić platformę, a kiedy budować samodzielnie
Integracja predykcji z systemem takim jak IBM Maximo i ograniczanie fałszywych alarmów SCADA to dwa najbardziej niedocenione elementy każdego wdrożenia PdM, ważniejsze niż wybór architektury modelu.
Jeśli twój zespół nie ma dedykowanych inżynierów MLOps i potrzebujesz wymiernego ROI w ciągu kilku miesięcy, kupno gotowej platformy jest racjonalniejsze niż budowa od zera. Budowa własnego stosu ma sens tylko wtedy, gdy masz silny zespół danych i realny apetyt na eksperymenty R&D wykraczające poza standardowe przypadki użycia. Moja rekomendacja jest prosta: zacznij pilotaż z dostawcą, który od pierwszego dnia oferuje integrację z systemem zarządzania pracą, nie z tym, kto oferuje najbardziej efektowny dashboard.
— Mateusz
Synaptix Platform: jak przejść od pilotażu do skalowania
Dostępne na rynku platformy mogą oferować rozwiązania wspierające automatyzację alertów zamieniających się w zlecenia pracy, a także moduły do monitorowania kondycji aktywów w czasie rzeczywistym oraz automatyzacji przetwarzania dokumentów serwisowych i ich kierowania do systemów ERP lub CMMS.
Platforma integruje się z protokołami przemysłowymi (MQTT, OPC‑UA, Modbus, M‑Bus) oraz z istniejącym CMMS i ERP, więc nie musisz budować warstwy integracyjnej od podstaw. Jeśli chcesz sprawdzić, jak wygląda to w praktyce na twoich aktywach, umów pilotaż lub demo Synaptix Platform i zobacz, ile czasu zajmie integracja z twoim obecnym CMMS.
Źródła
Warto sięgnąć do badania nad architekturą Unified Namespace w przemyśle, raportu McKinsey o skalowaniu predykcji w przemyśle oraz pracy o transfer learning w prognozowaniu RUL — trzy różne, ale wzajemnie uzupełniające się spojrzenia na skalowanie modelowania danych maszynowych.
- Prediction at scale: How industry can get more value out of maintenance
- A Novel Approach for Remaining Useful Life
Najczęściej zadawane pytania
Czym różni się detekcja anomalii od predykcji RUL?
Detekcja anomalii wykrywa odchylenie od normalnego zachowania maszyny bez precyzyjnego przewidywania czasu awarii, a RUL szacuje, ile czasu zostało do końca żywotności komponentu. Zwykle zaczyna się od anomalii, a RUL dodaje się dopiero, gdy zbierzesz wystarczającą historię degradacji.
Ile danych historycznych potrzebuję do pilotażu PdM?
Minimum 3 miesiące normalnej pracy maszyny wystarczy na wstępną detekcję anomalii, ale wiarygodny model RUL wymaga zwykle 12 miesięcy historii obejmującej pełny cykl degradacji.
Czy warto budować model samodzielnie, czy kupić platformę?
Budowa własna ma sens przy silnym zespole danych i realnych zasobach R&D, natomiast gotowa platforma jak Synaptix Platform skraca czas do pierwszego ROI, zwłaszcza gdy brakuje dedykowanego zespołu MLOps.
Jak długo trwa typowy pilotaż modelowania danych maszynowych?
Pierwsze zauważalne efekty pojawiają się po 6–9 miesiącach, a pełne skalowanie modeli RUL na wiele aktywów trwa zwykle od 12 do 24 miesięcy.
Co jest głównym powodem porażki wdrożeń PdM?
Najczęstszym powodem jest brak integracji alertów z systemem zarządzania pracą (CMMS) — model generuje trafne prognozy, ale nikt nie przekłada ich na rzeczywiste zlecenia serwisowe.