
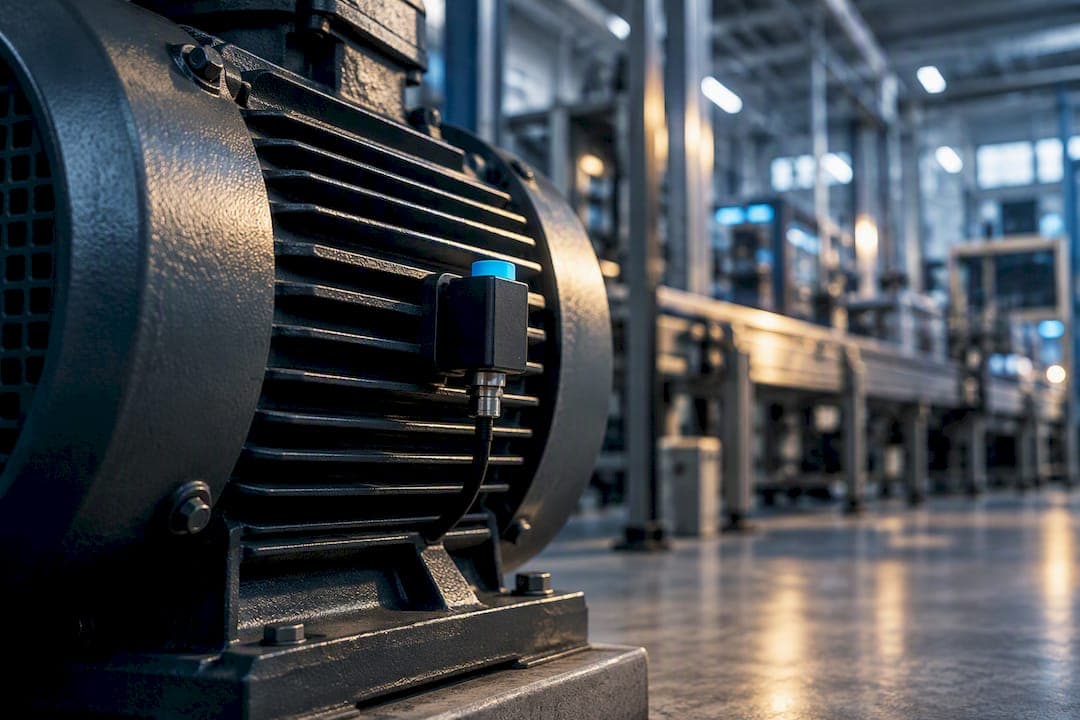
Aby skutecznie prowadzić monitoring silników elektrycznych, łączymy pomiary online, drgania, temperaturę i prąd, z okresowymi testami izolacji offline. Takie podejście pozwala przejść z konserwacji planowej na predykcyjną i realnie ograniczyć liczbę nieplanowanych awarii. Kluczem nie jest zbieranie danych, a analiza trendów w czasie, uzupełniona testami rezystancji izolacji (IR), wskaźnika polaryzacji (PI) i tan δ w regularnych odstępach. Efekt: mniej przestojów, przewidywalny harmonogram remontów i lepsze wskaźniki dostępności maszyn.
Krótko mówiąc:
- Monitoring silników elektrycznych opłaca się szczególnie w przypadkach krytycznych procesów, mocnych jednostek powyżej kilkudziesięciu kilowatów i trudnego dostępu do maszyn.
- Efektywna diagnostyka wymaga analizy trendów w czasie, łączącej pomiary online z okresowymi testami izolacji, takimi jak rezystancja IR i wskaźnik PI.
- Kluczowe metody pomiarowe obejmują analizę drgań, temperatury, prądu oraz wyładowań niezupełnych, a ich interpretacja wymaga odpowiedniej synchronizacji i filtrowania danych.
- Przy projektowaniu systemu monitoringu istotne jest ustalenie procedur reakcji na alarmy oraz integracja z systemami zgłoszeń serwisowych, by unikać fałszywych alarmów.
- W pilotażu monitoringowym najważniejsze jest skoncentrowanie się na krytycznych maszynach i scenariuszach awarii, które są najbardziej bolesne dla działalności.
Spis treści
- Dlaczego monitoring silników elektrycznych daje realną wartość
- Kluczowe sygnały i metody pomiarowe: online i offline
- Jak zaprojektować system monitoringu i przeprowadzić pilotaż
- Analiza danych i AI: jak ograniczyć fałszywe alarmy
- Checklist techniczny przed uruchomieniem monitoringu
- Praktyczny przykład: Synaptix w pilotażu monitoringu stanu
- Perspektywa autora: czego unikać na starcie
- Jak zacząć pilotaż monitoringu z Synaptix-platform
- Źródła
- Najczęściej zadawane pytania
Dlaczego monitoring silników elektrycznych daje realną wartość
Silnik, który nagle staje w trakcie zmiany, kosztuje znacznie więcej niż ten, który przechodzi zaplanowany remont w sobotę. Różnica nie leży w samej naprawie, a w utraconej produkcji, nadgodzinach serwisu i czasem w uszkodzeniach wtórnych, gdy uszkodzone łożysko rozrzuca metal po całym wirniku.
EPRI od lat dokumentuje, że programy predykcyjnego utrzymania dużych silników trójfazowych mogą przynieść wymierne oszczędności kosztów utrzymania, nawet w przedziale 30 do 50 procent w niektórych wdrożeniach, gdy dane z czujników są konsekwentnie łączone z procedurą eskalacji serwisowej.
Monitoring opłaca się szczególnie tam, gdzie:
- silnik napędza proces krytyczny, a jego przestój zatrzymuje całą linię,
- moc jednostkowa przekracza kilkadziesiąt kilowatów, co podnosi koszt awarii i naprawy,
- dostęp do maszyny jest utrudniony (praca w ruchu, wysoka temperatura, strefy zagrożone),
- historia utrzymania pokazuje powtarzalne awarie łożysk lub izolacji.
Warto pamiętać, że sprawność energetyczna silnika, klasyfikowana według normy IEC 60034-30-1 w skali IE1 do IE5, to zupełnie inny parametr niż jego stan techniczny. Silnik klasy IE4 może mieć uszkodzone łożysko tydzień po instalacji. Monitoring stanu i pomiar zużycia energii trzeba prowadzić równolegle, nie zamiennie.
Kluczowe sygnały i metody pomiarowe: online i offline
Skuteczny program diagnostyki silników elektrycznych opiera się na dwóch warstwach pomiarowych, które się wzajemnie uzupełniają.
- Drgania mechaniczne. Akcelerometry montowane na obudowie łożyska wykrywają niewyważenie, rozosiowanie i defekty bieżni łożyska. Do analizy defektów wysokoczęstotliwościowych potrzebne jest próbkowanie na poziomie co najmniej 20 kHz, bo tylko taka rozdzielczość pozwala rozłożyć sygnał na widmo w analizie FFT.
- Temperatura. Termopary lub czujniki RTD na łożyskach i w uzwojeniach wychwytują przegrzanie spowodowane przeciążeniem, złą wentylacją lub zaczynającą się degradacją izolacji.
- Prąd i napięcie. Cewki prądowe (CT) rejestrują asymetrię faz, wzrost prądu biegu jałowego i charakterystyczne harmoniki wskazujące na uszkodzenie prętów klatki wirnika. Prąd można próbkować rzadziej niż drgania, ale przy wysokiej rozdzielczości przetwornika analogowo-cyfrowego.
- Obciążenie i prędkość. Bez kontekstu procesowego trudno odróżnić realne uszkodzenie od zmiany warunków pracy, dlatego dane obciążenia i prędkości muszą trafiać do tego samego systemu co drgania i prąd.
- Wyładowania niezupełne (PD). Dla dużych maszyn wirujących ciągły monitoring PD wykrywa degradację izolacji zwojowej, zanim dojdzie do przebicia, a artykuł branżowy Nowa Energia opisuje praktyczne wdrożenia takiego monitoringu razem z bazami referencyjnymi typu IRIS.
Do interpretacji sygnałów online służą metryki RMS (poziom energii drgań), kurtoza (wykrywanie uderzeń typowych dla defektów łożysk), analiza FFT (rozkład częstotliwości), STFT i PSD (zmiany widma w czasie, przydatne przy zmiennej prędkości).
Testy offline uzupełniają ten obraz raz na kwartał lub raz w roku, zależnie od krytyczności maszyny: pomiar rezystancji izolacji (IR), wskaźnik polaryzacji (PI), tan δ oraz test napięciem udarowym (surge test) do wykrywania zwarć międzyzwojowych. Ich ograniczenie: wymagają wyłączenia silnika, a wynik trzeba czytać trendowo, nie jako pojedynczy odczyt, bo EPRI podkreśla wpływ wilgotności i temperatury na pomiar.
Jak zaprojektować system monitoringu i przeprowadzić pilotaż
Typowa architektura wygląda tak: czujnik na silniku przekazuje dane do lokalnego kontrolera edge, który filtruje szum i wstępnie agreguje sygnał, a następnie przesyła go do platformy w chmurze zintegrowanej z systemem CMMS lub ERP. Protokoły takie jak MQTT, OPC-UA, Modbus czy M-Bus zapewniają komunikację między czujnikiem a warstwą nadrzędną bez konieczności budowania własnego okablowania sterowniczego od zera.
Kilka parametrów technicznych decyduje o jakości danych:
- częstotliwość próbkowania drgań musi być dopasowana do najwyższej częstotliwości defektu, jaką chcemy wykryć,
- synchronizacja czasu między czujnikami jest niezbędna, gdy korelujemy drgania z prądem i obciążeniem,
- filtrowanie szumu elektrycznego trzeba wdrożyć już na poziomie edge, inaczej dane w chmurze są bezużyteczne.
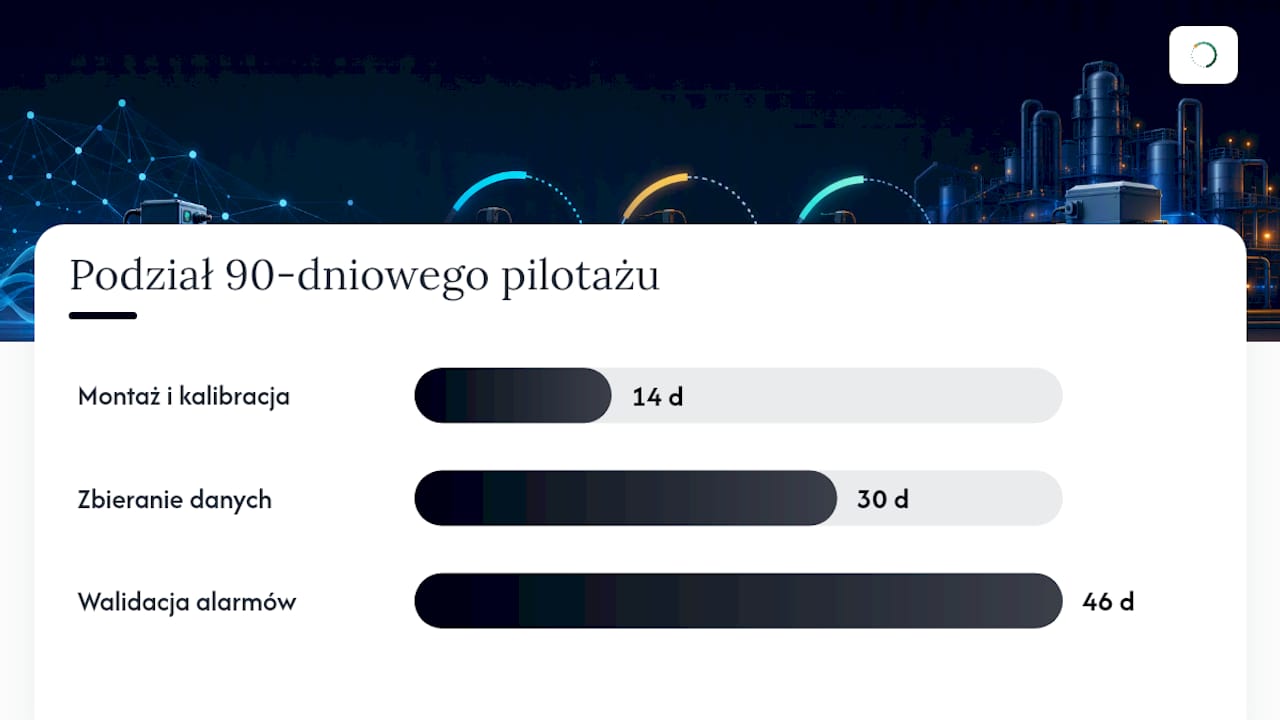
Pilotaż o długości 90 dni to sprawdzony punkt odniesienia w branży. Pierwsze dwa tygodnie przeznacza się na montaż czujników i kalibrację, kolejny miesiąc na zbieranie danych bazowych, a resztę czasu na walidację alarmów i porównanie ich z rzeczywistymi zgłoszeniami serwisowymi. Sukces pilotażu mierzy się nie liczbą wygenerowanych alertów, a tym, czy trafiły one do właściwego technika zanim maszyna stanęła.
Porada profesjonalisty: Zanim podłączysz pierwszy czujnik, zapytaj dział utrzymania, jakie trzy awarie bolały ich najbardziej w ostatnim roku. Zaprojektuj pilotaż tak, by wykrywał właśnie te scenariusze, nie generyczne „anomalie”.
Analiza danych i AI: jak ograniczyć fałszywe alarmy
Prosty próg alarmowy na drganiach, na przykład „powyżej 7 mm/s wygeneruj alert”, wygląda dobrze na papierze i zawodzi w praktyce. Silnik pracujący przy zmiennym obciążeniu i prędkości generuje inny poziom drgań w każdym punkcie pracy, a sztywny próg albo zaleje techników fałszywymi alarmami, albo przegapi realne uszkodzenie.
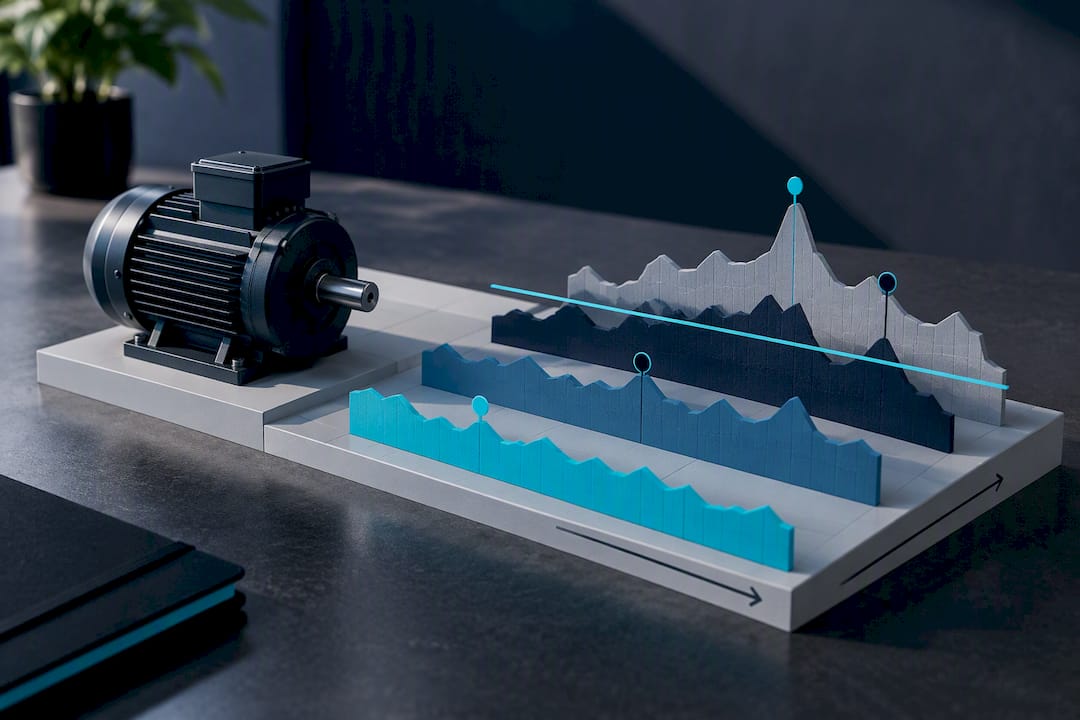
Publiczne zbiory danych z KAIST i podobnych źródeł badawczych dowodzą, że algorytmy detekcji trzeba trenować i walidować na danych obejmujących wiele warunków obciążenia, a nie na jednym punkcie pracy. Badania nad zbiorami danych z wielu typów uszkodzeń idą dalej i wskazują, że modele AI generują nadmiar fałszywych alarmów, jeśli nie uwzględniają kontekstu prędkości i obciążenia w momencie predykcji.
Praktyczne wnioski dla zespołu wdrażającego monitoring silników elektrycznych:
- ustaw progi dynamiczne, zależne od aktualnego obciążenia i prędkości, nie stałe wartości,
- łącz prostą logikę reguł (szybka detekcja oczywistych anomalii) z modelem uczenia maszynowego (wychwytywanie subtelnych trendów),
- waliduj model na danych z różnych zmian, pór roku i punktów pracy, nie tylko na danych z rozruchu,
- monitoruj odsetek fałszywych alarmów (FPR) i wykrywalność (TPR) jako osobne wskaźniki jakości modelu, nie jeden łączny wynik.
INL i EPRI zauważają, że sama instrumentacja i analiza nic nie dają, jeśli nie są powiązane z konkretną procedurą eskalacji serwisowej. Dashboard pełen wykresów, na który nikt nie reaguje, to koszt bez zwrotu. Więcej o projektowaniu takich procedur alarmowych znajdziesz w tekście o ograniczaniu zmęczenia alarmami w systemach SCADA.
Checklist techniczny przed uruchomieniem monitoringu
Zanim system pójdzie w ruch produkcyjny, zespół techniczny powinien przejść przez kilka punktów kontrolnych.
- Montaż czujników na obudowie łożyska w miejscu wskazanym przez producenta, z udokumentowaną trasą kablową i osłoną przed wibracjami mechanicznymi niepochodzącymi od silnika.
- Zasilanie i uziemienie czujników sprawdzone pod kątem zakłóceń elektromagnetycznych, szczególnie przy przetwornicach częstotliwości.
- Kalibracja i testy akceptacyjne każdego czujnika względem znanego wzorca, z zapisanym protokołem odniesienia.
- Konfiguracja próbkowania w oprogramowaniu, z etykietami urządzeń zgodnymi z numeracją w CMMS, żeby alert od razu wskazywał konkretną maszynę.
- Integracja z systemem zleceń serwisowych, tak by alarm generował zadanie, a nie tylko powiadomienie e-mail, które ktoś przegapi.
- Ustalone progi, priorytety i właściciele zadań dla każdego typu alarmu, zapisane w jednym dokumencie dostępnym dla zmiany.
Integrację czujnika ze zleceniem serwisowym opisuje szerzej materiał o łączeniu CMMS z danymi z czujników IoT.
Praktyczny przykład: Synaptix w pilotażu monitoringu stanu
Platforma Synaptix łączy dwa moduły istotne dla tego procesu. GridSense zbiera i analizuje w czasie rzeczywistym dane z czujników drgań, temperatury i prądu, wychwytując anomalie zanim staną się awarią. AutomateFlow automatyzuje przepływ zgłoszeń serwisowych, kierując je bezpośrednio do systemów SAP lub Maximo bez ręcznego przepisywania danych.
Typowy pilotaż obejmuje:
- integrację czujników istniejących lub nowo zamontowanych z GridSense przez protokoły MQTT lub OPC-UA,
- zdefiniowanie progów alarmowych dopasowanych do konkretnego typu maszyny,
- automatyczne generowanie zleceń w CMMS przez AutomateFlow po przekroczeniu progu,
- porównanie liczby nieplanowanych przestojów przed i po wdrożeniu.
Więcej o strukturze takiego programu znajdziesz w opisie pilotażu utrzymania predykcyjnego dla wodociągów, gdzie podobny model integracji sprawdzono w innym sektorze użyteczności publicznej.
Perspektywa autora: czego unikać na starcie
Najczęstszy błąd to instalacja czujników bez zdefiniowanej procedury reakcji na alarm. Drugi to poleganie na jednym sztywnym progu drgań bez kontekstu obciążenia. W pierwszych 30 dniach pilotażu warto skupić się na jednej krytycznej maszynie, jednym wyraźnym scenariuszu awarii i jasnym właścicielu każdego alertu, zamiast rozpraszać zasoby na cały park maszynowy.
— Mateusz
Jak zacząć pilotaż monitoringu z Synaptix-platform
Synaptix-platform to sposób na wdrożenie monitoringu stanu bez budowania własnego zespołu analityków danych od podstaw. Moduł GridSense przejmuje ciągłą analizę sygnałów z czujników, a AutomateFlow eliminuje ręczne przepisywanie zgłoszeń między systemami, co zwykle pochłania najwięcej czasu techników w pierwszych miesiącach po wdrożeniu.
Firma proponuje trzy warianty współpracy: ograniczony zakres testowy, pełne wdrożenie produkcyjne oraz rozwiązania dla organizacji z wieloma zakładami i złożoną integracją systemową. Szczegóły każdego wariantu, w tym zakres integracji z CMMS i ERP, znajdziesz na stronie z cennikiem. Jeśli rozważasz pilotaż 90-dniowy opisany wcześniej, to właśnie tam zaczyna się rozmowa o zakresie i celach wdrożenia, a pełny obraz możliwości platformy sprawdzisz na stronie głównej Synaptix.
Źródła
Do dalszej lektury: wytyczne EPRI dotyczące predykcyjnego utrzymania silników, norma IEC 60034-30-1:2025, zbiory danych badawczych z KAIST i Mendeley oraz raport INL/OSTI o monitoringu online silników indukcyjnych.
- IEC 60034-30-1:2025
- Vibration, acoustic, temperature, and motor current dataset of rotating machine under varying load conditions
- Online Monitoring of Induction Motors (INL/EPRI)
- Wdrożenie monitoringu stanu silników elektrycznych – Nowa Energia
Najczęściej zadawane pytania
Jak sprawdzić sprawność techniczną silnika elektrycznego?
Sprawność techniczną ocenia się przez kombinację pomiarów online, drgań, temperatury i prądu, oraz okresowych testów offline izolacji: rezystancji (IR), wskaźnika polaryzacji (PI) i tan δ. Same odczyty chwilowe mówią mało, decyduje trend zmian w czasie na podstawie kilku kolejnych pomiarów.
Jakie są rodzaje zabezpieczeń silników elektrycznych?
Typowe zabezpieczenia obejmują przekaźniki termiczne przed przegrzaniem, zabezpieczenia przeciążeniowe i zwarciowe, monitoring asymetrii faz oraz coraz częściej ciągły monitoring wyładowań niezupełnych w dużych maszynach wirujących, opisany w kontekście wdrożeń przemysłowych. Zabezpieczenia elektryczne chronią przed uszkodzeniem natychmiastowym, a monitoring stanu wychwytuje degradację postępującą tygodniami lub miesiącami.
Jaki jest najwydajniejszy silnik elektryczny pod względem energetycznym?
Najwyższą sprawność energetyczną mają silniki klasy IE5 według normy IEC 60034-30-1, obejmującej zakres od 0,12 do 1000 kW. To jednak parametr projektowy silnika, niezależny od jego bieżącego stanu technicznego, który wymaga osobnego monitoringu.
Jakie są klasy sprawności silników elektrycznych?
Norma IEC 60034-30-1 wyróżnia klasy od IE1 (standardowa) do IE5 (ultra premium), rosnąco według sprawności energetycznej przy pełnym obciążeniu. Klasa sprawności nie zastępuje diagnostyki stanu technicznego, bo nawet silnik klasy IE5 wymaga monitoringu drgań i izolacji, żeby uniknąć awarii.
Czym różni się konserwacja predykcyjna od planowej?
Konserwacja planowa opiera się na sztywnym harmonogramie kalendarzowym, niezależnym od faktycznego stanu maszyny. Konserwacja predykcyjna wykorzystuje dane z czujników i trendy sygnałów do zaplanowania interwencji dokładnie wtedy, gdy maszyna tego wymaga, co według wytycznych EPRI może ograniczyć koszty utrzymania nawet o 30 do 50 procent w niektórych programach.
Ile kosztuje wdrożenie monitoringu silników z Synaptix-platform?
Aktualne ceny wariantów Pilot, Platform i Enterprise dostępne są na stronie z cennikiem Synaptix, gdzie zakres i koszt zależą od liczby integrowanych modułów i skali wdrożenia.