
NLP w dokumentach technicznych automatyzuje wyszukiwanie, ekstrakcję i streszczanie informacji, skracając czas dostępu do wiedzy i ograniczając ręczną pracę inżynierów. Sprawdza się tam, gdzie firma przetwarza duże wolumeny instrukcji, protokołów czy specyfikacji i potrzebuje szybkich, powtarzalnych decyzji. Pełny efekt daje dopiero połączenie OCR, semantycznego dzielenia tekstu i hybrydowego wyszukiwania z kontrolą jakości. Dalsze sekcje pokazują, jak zbudować taki schemat od zera i od czego zacząć pilota.
Krótko mówiąc:
- NLP w dokumentach technicznych najlepiej działa w powtarzalnych scenariuszach, takich jak ekstrakcja parametrów czy automatyczna klasyfikacja, z wysoką skutecznością przy poprawnej implementacji.
- W pełnym pipeline konieczne jest zastosowanie OCR do digitalizacji, semantyczne dzielenie tekstu i hybrydowe wyszukiwanie, aby uniknąć utraty kontekstu podczas analizy.
- Modele językowe mogą generować wiarygodne, ale niepotwierdzone informacje, dlatego ważne jest wymuszenie cytowania źródła i weryfikacja przez inżyniera.
- Pilot NLP powinien zacząć się od ograniczonego zbioru dokumentów, z jasno określonym obszarem zastosowania, aby zmierzyć dokładność i oszczędności czasowe.
- Wdrożenie w praktyce wymaga integracji z systemami takimi jak CMMS czy ERP, oraz współpracy inżynierów z zespołami technologii lub utrzymania ruchu.
Spis treści
- Czym różni się OCR od NLP w dokumentach technicznych?
- Jak zbudować pipeline od skanu PDF do gotowych danych?
- Gdzie NLP realnie pomaga w dokumentach technicznych?
- Gdzie NLP może się mylić i jak to kontrolować?
- Jak zaplanować pilota NLP dla dokumentów technicznych?
- Jak wygląda wdrożenie NLP w praktyce przemysłowej?
- Kiedy inwestować w NLP dla dokumentów technicznych?
- Jak zacząć współpracę z Synaptix przy automatyzacji dokumentów?
- Źródła
- Najczęściej zadawane pytania
Czym różni się OCR od NLP w dokumentach technicznych?
OCR odczytuje znaki ze skanu lub zdjęcia i zamienia je na tekst edytowalny. Radzi sobie słabo z układem strony, tabelami rozciągniętymi na kilka kolumn, ręcznymi wpisami na formularzach serwisowych i niską jakością skanu. To narzędzie do odczytu, nie do rozumienia.
NLP zaczyna tam, gdzie OCR kończy. Przetwarzanie języka naturalnego analizuje znaczenie tekstu i wykonuje konkretne zadania:
- rozpoznawanie encji nazwanych (NER) — wyłapywanie numerów seryjnych, jednostek, dat przeglądów, nazw komponentów,
- klasyfikacja dokumentów według typu i priorytetu,
- ekstrakcja par klucz-wartość, na przykład „moc znamionowa: 45 kW”,
- streszczanie długich raportów do sekcji istotnych dla decyzji,
- wyszukiwanie semantyczne, które znajduje odpowiedź nawet bez dokładnego dopasowania słów.
Sam OCR wystarczy, gdy chcesz jedynie zdigitalizować archiwum i przeszukiwać je frazami. Pełny pipeline z modelami kontekstowymi jest potrzebny, gdy trzeba wydobyć dane liczbowe, porównać wersje dokumentów albo automatycznie kierować sprawy do odpowiedniego działu. Automatyzacja dokumentów z AI pokazuje, że połączenie obu technik przy poprawnej implementacji daje wysoką dokładność przetwarzania, znacznie wyższą niż jedna z nich osobno.
Jak zbudować pipeline od skanu PDF do gotowych danych?
Praktyczny schemat wdrożenia NLP w dokumentacji technicznej wygląda podobnie niezależnie od branży, choć szczegóły różnią się w zależności od typu dokumentu.
- Przyjęcie plików — normalizacja formatów (PDF, skan, zdjęcie z terenu) i wstępna walidacja jakości.
- OCR i odczyt układu — rozpoznanie tekstu z zachowaniem struktury: nagłówków, tabel, kolumn.
- Semantyczne dzielenie tekstu (chunking) — podział dokumentu na fragmenty zachowujące kontekst, szczególnie ważny dla tabel i bloków kodu.
- Tworzenie embeddingów — zamiana fragmentów na wektory reprezentujące znaczenie.
- Hybrydowe wyszukiwanie — połączenie wyszukiwania wektorowego z klasycznym BM25, co ogranicza pomijanie trafnych fragmentów.
- Reranking i generacja odpowiedzi (RAG) — model językowy formuje odpowiedź na podstawie wyszukanych fragmentów, cytując źródło.
- Walidacja i integracja — sprawdzenie wyniku i przekazanie danych do systemu docelowego (CMMS, ERP, DMS).
RAG łączy wyszukiwanie wektorowe, BM25 i reranking LLM, a odpowiedzi ograniczone do cytowanych fragmentów wyraźnie zmniejszają ryzyko halucynacji modelu. W zbiorach przekraczających 10 tysięcy dokumentów sprawdza się dodatkowo fuzja rankingów i wyszukiwanie hierarchiczne, które przyspiesza dostęp do właściwej sekcji bez przeszukiwania całej bazy.
Porada profesjonalisty: Nie dziel tabel technicznych na fragmenty według liczby znaków. Ustal reguły chunkingu tak, by cała tabela lub blok kodu trafiał do jednego fragmentu, inaczej model zgubi kontekst. jednostek i zależności między kolumnami.
Więcej o samym etapie odczytu skanów znajdziesz w przewodniku po OCR dla dokumentów technicznych.
Gdzie NLP realnie pomaga w dokumentach technicznych?
Automatyzacja analizy dokumentów daje najwięcej wartości w kilku powtarzalnych scenariuszach, z którymi codziennie mierzą się działy inżynierii i utrzymania ruchu.
- Preselekcja przetargów i SIWZ — automatyczne wyłapywanie wymagań, terminów i kryteriów wykluczenia z setek stron specyfikacji.
- Ekstrakcja parametrów technicznych — wydobywanie tolerancji, jednostek i norm z kart katalogowych oraz instrukcji obsługi.
- Raporty pomiarowe i protokoły serwisowe — zamiana odręcznych lub półstrukturalnych notatek na dane gotowe do analizy trendów.
- Zlecenia utrzymania ruchu — klasyfikacja i routing zgłoszeń do właściwego zespołu na podstawie opisu usterki.
- Baza wiedzy dla techników — wyszukiwanie semantyczne pozwala znaleźć procedurę, nawet gdy technik nie znajdzie dokładnej frazy z instrukcji.
Konkretny przykład z branży budowlanej: projekt automatyzacji analizy dokumentów przetargowych przyniósł wymierną oszczędność czasu i redukcję błędów finansowych przy ocenie ofert. To pokazuje, że NLP nie musi obejmować całej dokumentacji firmy, żeby dać zauważalny efekt. Warto zacząć od jednego typu dokumentu, w którym objętość i powtarzalność są największe. Klasyfikacja dokumentów według typu, opisana szerzej w metodzie porządkowania dokumentacji utrzymania ruchu, często jest pierwszym krokiem przed właściwą ekstrakcją danych.
Gdzie NLP może się mylić i jak to kontrolować?
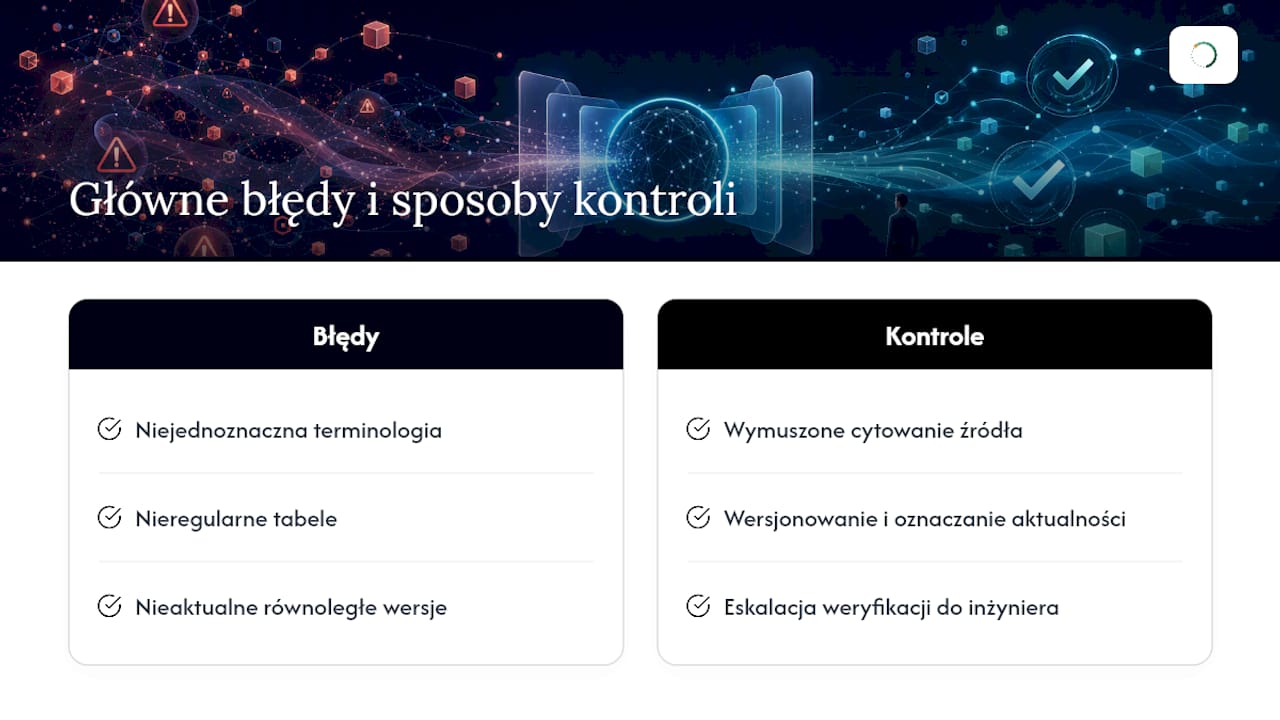
Modele językowe nie rozumieją dokumentacji technicznej tak jak inżynier z dziesięcioletnim stażem. Trzy źródła błędów powtarzają się najczęściej: niejednoznaczna terminologia branżowa (ten sam skrót oznacza różne parametry w różnych normach), tabele o nieregularnym formatowaniu oraz nieaktualne wersje dokumentów krążące równolegle z aktualnymi.
Największym ryzykiem są halucynacje modelu, czyli generowanie odpowiedzi, która brzmi wiarygodnie, ale nie ma potwierdzenia w źródle. W dokumentacji technicznej to szczególnie niebezpieczne przy parametrach krytycznych dla bezpieczeństwa, na przykład tolerancjach ciśnienia czy temperatury granicznej.
Trzy mechanizmy kontrolne ograniczają to ryzyko: wymuszenie cytowania fragmentu źródłowego przy każdej odpowiedzi, wersjonowanie dokumentów z jasnym oznaczeniem aktualności oraz proces eskalacji, w którym inżynier weryfikuje wynik przed jego wykorzystaniem.
Porada profesjonalisty: Traktuj każdą liczbę wygenerowaną przez model jak cytat wymagający źródła. Jeśli system nie wskaże dokładnego fragmentu, z którego pochodzi parametr, nie wprowadzaj tej wartości do systemu produkcyjnego bez ręcznej weryfikacji.
Jak zaplanować pilota NLP dla dokumentów technicznych?
Pilot ma sens tylko wtedy, gdy ma jasny zakres i mierzalny cel od pierwszego dnia. Sprawdzony plan wygląda następująco:
- Inwentaryzacja dokumentów — jakie typy, w jakim formacie, ile stron miesięcznie.
- Wybór jednego przypadku użycia — najlepiej tego z największym wolumenem i najbardziej powtarzalną strukturą.
- Przygotowanie danych — czyszczenie, ujednolicenie formatów, oznaczenie próbki referencyjnej do testów.
- Budowa proof-of-concept OCR plus NLP — pierwsza wersja pipeline na ograniczonym zbiorze dokumentów.
- Walidacja z inżynierami dziedzinowymi — porównanie wyników modelu z wiedzą eksperta, nie tylko z metrykami technicznymi.
- Integracja i skalowanie — podłączenie do CMMS lub ERP i rozszerzenie na kolejne typy dokumentów.
Sukces mierzy się kilkoma wskaźnikami: dokładnością ekstrakcji, odsetkiem rekordów wymagających ręcznej korekty, czasem odpowiedzi na zapytanie oraz zwrotem z inwestycji liczonym w godzinach zaoszczędzonej pracy. Sukces wdrożenia zależy bardziej od jakości danych i współpracy z ekspertami dziedzinowymi niż od wyboru konkretnego modelu językowego, co warto zapamiętać przed inwestowaniem czasu w porównywanie modeli.
Realistyczny harmonogram: sam proof-of-concept trwa zwykle od 4 do 8 tygodni, a pełne wdrożenie produkcyjne rozkłada się na kolejne miesiące, etapami dla poszczególnych typów dokumentów. Praktyczny przykład takiego tempa opisuje wdrożenie ekstrakcji danych z PDF dla zespołów utrzymania ruchu.
Jak wygląda wdrożenie NLP w praktyce przemysłowej?
Automatyzacja przepływu dokumentów w Synaptix-platform opiera się na module AutomateFlow, który łączy OCR, NLP i routing wyników do systemów SAP i Maximo. Dane wydobyte z dokumentacji można później skierować do modułu GridSense, odpowiedzialnego za monitorowanie stanu aktywów w czasie rzeczywistym, co spina dokumentację techniczną z bieżącymi danymi z maszyn.
W praktyce liczy się kilka rzeczy jednocześnie:
- integracja z istniejącym CMMS lub ERP, bez zmuszania zespołu do pracy w nowym, oddzielnym systemie,
- walidacja wyników przez inżynierów przed pierwszym pełnym wdrożeniem produkcyjnym,
- jasny podział ról: kto poprawia błędy modelu, kto zatwierdza dane krytyczne dla bezpieczeństwa.
Miejsce na szczegółowe case studies z konkretnymi liczbami wdrożeniowymi i referencjami klientów zostaje otwarte. Deklarowane przez Synaptix ograniczenie nieplanowanych przestojów o 30 do 50 procent dotyczy głównie warstwy predykcyjnej, ale ta sama architektura event sourcing wspiera też integrację danych z dokumentów.
Kiedy inwestować w NLP dla dokumentów technicznych?
Pilota warto uruchomić od razu, gdy masz duży, powtarzalny zbiór dokumentów i konkretny problem operacyjny do rozwiązania. Jeśli dane są rozproszone, nieaktualne albo niestandaryzowane, najpierw poświęć czas na ich porządkowanie, bo żaden model nie naprawi bałaganu w źródle. Zacznij od jednego obszaru z jasnymi wskaźnikami sukcesu i od pierwszego dnia zaangażuj inżynierów, którzy zweryfikują wyniki.
— Mateusz
Jak zacząć współpracę z Synaptix przy automatyzacji dokumentów?
Synaptix-platform oferuje architekturę opartą na mikroserwisach i event sourcing oraz automatyzację przepływów dokumentów, redukując konieczność ręcznego przepisywania danych do systemów takich jak ChatBot IA - Glass Manager czy Maximo.
Współpraca zaczyna się od jednego z trzech poziomów: Pilot, czyli ograniczony zakres testowy na wybranym typie dokumentów, Platform z pełnym zestawem modułów włącznie z AutomateFlow i GridSense, oraz Enterprise dla organizacji z rozproszonymi lokalizacjami i wieloma protokołami przemysłowymi (MQTT, OPC-UA, Modbus, M-Bus). Ceny dla każdego poziomu są dostępne po kontakcie na stronie z ofertą Synaptix.
Zanim zgłosisz się do pilota, przygotuj próbkę dokumentów i osobę z zespołu technicznego gotową do walidacji wyników. Bez tego etapu nawet najlepszy model nie da wiarygodnych danych na wejściu. Szczegóły modułów i pełną ofertę znajdziesz na stronie głównej Synaptix Platform.
Najczęściej zadawane pytania
Co to znaczy NLP w kontekście dokumentów technicznych?
NLP, czyli przetwarzanie języka naturalnego, to zestaw technik uczenia maszynowego, które analizują znaczenie tekstu, nie tylko jego zapis. W dokumentach technicznych oznacza to automatyczne rozpoznawanie parametrów, klasyfikację treści i wyszukiwanie odpowiedzi na podstawie sensu zapytania, a nie dokładnego dopasowania słów.
Jakie są główne techniki NLP stosowane w analizie dokumentów?
Najczęściej wykorzystywane są rozpoznawanie encji nazwanych (NER), klasyfikacja tekstu, ekstrakcja par klucz-wartość, streszczanie oraz wyszukiwanie semantyczne wsparte przez architekturę RAG. W dokumentach technicznych dodaje się jeszcze semantyczne dzielenie tekstu, które zachowuje integralność tabel i danych liczbowych.
Czym różni się NLP od zwykłego OCR?
OCR odczytuje znaki ze skanu i zamienia je na tekst, ale nie rozumie jego treści. NLP działa na już odczytanym tekście i wykonuje zadania wymagające rozumienia znaczenia, takie jak klasyfikacja, ekstrakcja danych czy odpowiadanie na pytania.
Czy NLP w dokumentach technicznych bywa zawodne?
Tak, głównie przy niejednoznacznej terminologii, nieregularnych tabelach i nieaktualnych wersjach dokumentów. Dlatego proces powinien zawierać cytowanie źródła każdej wygenerowanej wartości oraz weryfikację przez inżyniera przed wykorzystaniem danych w decyzjach krytycznych dla bezpieczeństwa.
Czy Synaptix-platform obsługuje integrację z CMMS i ERP?
Tak, moduł AutomateFlow automatyzuje przetwarzanie dokumentów i przekazuje dane do systemów takich jak SAP i Maximo. Pełny zakres integracji i protokołów przemysłowych opisano na stronie oferty Synaptix.