
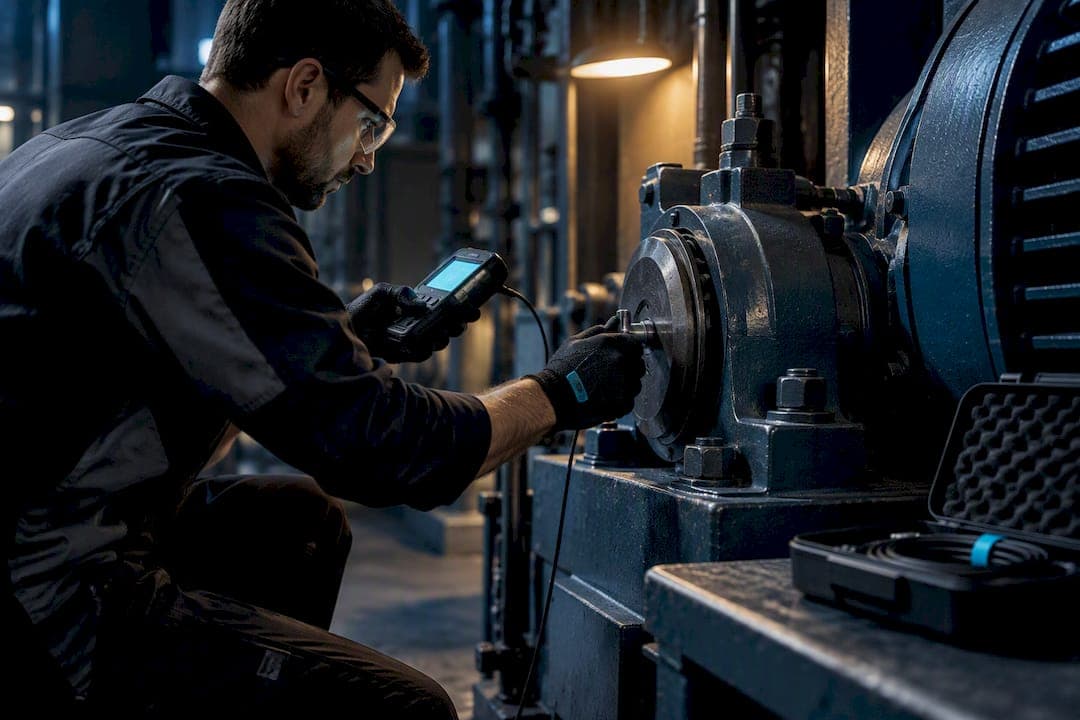
Konserwacja oparta na stanie (CBM) uruchamia interwencje tylko wtedy, gdy mierzalne parametry wskazują na zużycie, dzięki czemu redukuje nieplanowane awarie i ogranicza zbędne przeglądy. Zamiast harmonogramu opartego na kalendarzu, decyzję podejmują dane z czujników skonfrontowane z ustaloną linią bazową. Skuteczne wdrożenie wymaga trzech elementów: czujników dobranych do konkretnego trybu awarii, jasno zdefiniowanego punktu odniesienia oraz integracji z systemem CMMS, który zamienia alert w konkretne zlecenie robocze.
Krótko mówiąc:
- Inwestycja w monitorowanie stanu maszyn jest opłacalna głównie dla aktywów o wysokiej krytyczności i dobrze udokumentowanej historii awarii.
- Wdrożenie CBM wymaga dokładnego audytu, wyboru odpowiednich czujników, ustanowienia linii bazowej oraz integracji z systemem CMMS.
- Skuteczność programu zależy od jakości danych i filtracji, a początkowe progi alarmowe często generują wiele fałszywych alertów, wymagających korekt.
- Pilotowe wdrożenie trwa zazwyczaj około dwunastu tygodni i obejmuje instalację czujników, zbieranie danych, analizę i weryfikację alertów.
- Synaptix Platform ułatwia testowanie CBM, integrując dane z czujników, modele predykcyjne i automatyzację procesów w jednym środowisku.
Spis treści
- Czym różni się CBM od konserwacji zapobiegawczej i predykcyjnej
- Które aktywa monitorować, żeby inwestycja się zwróciła
- Plan wdrożenia CBM od audytu do skalowania pilota
- Czujniki, jakość danych i reguły ograniczające fałszywe alarmy
- Jak zamienić alert na wykonalne zlecenie w CMMS
- KPI, symulacje i pułapki przy ocenie opłacalności
- Lista kontrolna na pierwsze 90 dni pilota
- Czego nauczyło mnie wdrażanie programów CBM
- Synaptix Platform jako droga do przetestowania CBM we własnym zakładzie
- Źródła
- Najczęściej zadawane pytania
Czym różni się CBM od konserwacji zapobiegawczej i predykcyjnej
Konserwacja oparta na stanie polega na obserwowaniu rzeczywistego stanu technicznego maszyny i podejmowaniu działań serwisowych dopiero, gdy parametry przekroczą ustalony próg. Różni się to od konserwacji zapobiegawczej (PM), która wykonuje przeglądy w ustalonych odstępach czasu niezależnie od faktycznego zużycia komponentu, co często prowadzi do wymiany sprawnych części albo, odwrotnie, do przeoczenia awarii między przeglądami.

Konserwacja predykcyjna (PdM) idzie o krok dalej niż CBM: nie tylko wykrywa aktualny stan, ale prognozuje, kiedy dojdzie do awarii, wykorzystując modele statystyczne lub uczenie maszynowe do szacowania pozostałego czasu życia komponentu (RUL). CBM jest więc fundamentem, na którym budowane są bardziej zaawansowane prognozy.
Procedury wdrożeniowe CBM opisuje norma ISO 17359:2018, która wskazuje konieczność audytu sprzętu, wyboru lokalizacji pomiaru, ustalenia danych bazowych oraz kryteriów alarmowych. To dokument, do którego warto wracać przy każdym etapie projektowania programu monitorowania, ponieważ porządkuje kolejność decyzji technicznych.
Które aktywa monitorować, żeby inwestycja się zwróciła
Nie każda maszyna zasługuje na czujniki i model predykcyjny. Selekcję warto oprzeć na analizie krytyczności obejmującej skutki awarii, mierzalność degradacji i dostępny czas ostrzegawczy.
- Wpływ awarii na produkcję: sprawdź, czy przestój tego urządzenia zatrzymuje całą linię czy tylko lokalny proces.
- Mierzalność degradacji: niektóre uszkodzenia rozwijają się w sposób, który da się wychwycić czujnikiem wibracji lub temperatury na wiele tygodni przed awarią, inne nie.
- Czas ostrzegawczy: jeśli od pierwszego sygnału do awarii mija kilka minut, CBM nie zdąży wygenerować użytecznego alertu.
Prosty scoring krytyczności polega na przypisaniu punktów każdemu z tych kryteriów i zsumowaniu wyniku dla każdego aktywa, co pozwala uszeregować maszyny według priorytetu inwestycyjnego. Dla urządzeń o niskim wpływie na produkcję i niskim koszcie naprawy strategia run to failure, czyli praca do awarii bez interwencji zapobiegawczej, bywa ekonomicznie racjonalniejsza niż instalacja czujników.
Plan wdrożenia CBM od audytu do skalowania pilota
Wdrożenie CBM przebiega najlepiej jako sekwencja etapów, w której każdy kolejny krok zawęża ryzyko przed przejściem do kosztowniejszego działania.
- Audyt aktywów i trybów awarii: zidentyfikuj, jakie uszkodzenia historycznie powodowały przestoje i jakie sygnały im towarzyszyły.
- Wybór punktów pomiarowych: określ, gdzie i jak często mierzyć parametr, żeby uchwycić trend zanim dojdzie do awarii.
- Instalacja czujników i infrastruktury transmisji danych: dobierz protokół komunikacji (na przykład MQTT, OPC-UA lub Modbus) zgodny z istniejącą architekturą.
- Ustalenie linii bazowej: zbierz dane w warunkach normalnej pracy, żeby mieć punkt odniesienia dla odchyleń.
- Definiowanie progów alarmowych: ustal wartości, które oddzielają normalną zmienność od sygnału ostrzegawczego.
- Integracja z CMMS: skonfiguruj automatyczne generowanie zleceń na podstawie przekroczenia progu.
- Pilotaż na wybranej grupie maszyn: ograniczony zakres pozwala zweryfikować logikę alarmów bez ryzyka dla całego zakładu.
- Ewaluacja i korekta: porównaj liczbę fałszywych alarmów i rzeczywistych wykryć z oczekiwaniami, zanim zdecydujesz o skalowaniu.
Realistyczny pilot trwa najczęściej około dwunastu tygodni i wymaga zaangażowania osoby technicznej do instalacji czujników oraz analityka do interpretacji pierwszych danych. Minimalny zestaw dowodów przed skalowaniem obejmuje: liczbę wygenerowanych alertów, ich trafność potwierdzoną fizyczną inspekcją oraz porównanie kosztu reakcji z kosztem hipotetycznej awarii, której udało się zapobiec. Szczegóły organizacji takiego etapu opisuje plan pilotażu utrzymania predykcyjnego.
Porada profesjonalisty: zacznij pilot od maszyn, których historia awarii jest dobrze dokumentowana, bo to ułatwia weryfikację, czy alerty CBM faktycznie wyprzedzają realne problemy.
Czujniki, jakość danych i reguły ograniczające fałszywe alarmy
Wybór czujnika zależy od trybu awarii, który chcesz wykryć. Drgania mechaniczne wskazują na niewyważenie, luzy łożyskowe lub problemy ze sprzęgłem. Temperatura sygnalizuje przegrzanie łożysk, silników lub układów smarowania. Ciśnienie ujawnia nieszczelności lub zatory w układach hydraulicznych i pneumatycznych. Jakość oleju, mierzona zawartością wody, metali i zanieczyszczeń, wskazuje na postępujące zużycie wewnętrzne. Prąd silnika pozwala wykryć przeciążenie lub degradację izolacji uzwojeń.
- Drgania: akcelerometry piezoelektryczne montowane bezpośrednio na obudowie łożyska.
- Temperatura: termopary lub kamery termowizyjne w punktach krytycznych.
- Jakość oleju: czujniki wilgotności i cząstek metalicznych w obiegu smarowania.
Inicjalizacja modeli wymaga okresu run in, czyli fazy stabilizacji danych po instalacji czujnika lub po remoncie. Praktyka rynkowa wskazuje na minimum trzydziestu dni stabilnych danych przed uznaniem linii bazowej za wiarygodną, a okres bezpośrednio po naprawie warto wyłączyć z treningu modelu, bo zawiera nietypowe wartości.
Reguły wieloetapowe redukują liczbę fałszywych alarmów skuteczniej niż pojedynczy próg. Badanie opublikowane w MDPI w 2026 roku wykazało, że zastosowanie wieloetapowej filtracji danych i adaptacji modelu z wyjaśnialną sztuczną inteligencją (XAI) obniża liczbę fałszywych alarmów o około 90% w złożonych systemach. Praktyczna logika decyzyjna łączy więc filtrowanie jakości danych, filtrowanie czasowe (odrzucanie pojedynczych skoków bez trwałego trendu) i reguły potwierdzenia, które wymagają przekroczenia progu przez kilka kolejnych odczytów, zanim system wygeneruje alert.
Jak zamienić alert na wykonalne zlecenie w CMMS
Alert bez konsekwencji operacyjnej jest kosztem, nie korzyścią. Skuteczny wzorzec integracji mapuje przekroczenie progu na konkretne zlecenie robocze z przypisanym priorytetem i dostępnymi zasobami, zamiast zostawiać interpretację techniki na miejscu.
Integracja techniczna opiera się na API łączącym system monitorowania z CMMS oraz na sanityzacji danych, czyli odfiltrowaniu duplikatów i błędnych odczytów przed przekazaniem ich dalej. Liczbę generowanych zleceń kontroluje się poprzez grupowanie powiązanych alertów w jedno zgłoszenie i ustalenie SLA odpowiadającego rzeczywistej krytyczności aktywa, a nie jednakowego dla wszystkich maszyn. Praktyczny przykład takiej integracji opisuje pilotaż CMMS z danymi z czujników IoT.

KPI, symulacje i pułapki przy ocenie opłacalności
Ocenę programu CBM warto oprzeć na kilku wskaźnikach, które razem pokazują, czy inwestycja się zwraca.
- MTTR (średni czas naprawy): pokazuje, czy wcześniejsze wykrycie problemu skraca czas reakcji.
- MTBF (średni czas między awariami): rosnący trend sugeruje, że program faktycznie zapobiega uszkodzeniom.
- Liczba nieplanowanych przestojów: najbardziej bezpośredni wskaźnik skuteczności CBM.
- Koszt przestoju: pozwala przeliczyć uniknięte awarie na wartość finansową.
Zanim zdecydujesz się na skalowanie programu na cały zakład, analiza NIST opartej na przeglądzie 42 publikacji z lat 2001 do 2023 wskazuje, że ocena systemów monitorowania stanu wymaga symulacji i analizy niepewności, ponieważ porównywalność wyników ekonomicznych między różnymi wdrożeniami jest z natury ograniczona. Oznacza to, że wynik osiągnięty w jednym zakładzie nie przenosi się automatycznie na inny, nawet przy podobnym parku maszynowym.
Do typowych pułapek należy nadmierne zaufanie do prognoz RUL bez uwzględnienia marginesu bezpieczeństwa, co w systemach krytycznych bywa kosztowne przy zbyt optymistycznych szacunkach.
Lista kontrolna na pierwsze 90 dni pilota
- Wybierz maksymalnie pięć aktywów o wysokiej krytyczności i dobrze znanej historii awarii.
- Zainstaluj czujniki i zbieraj dane bazowe minimum 30 dni przed ustaleniem progów.
- Skonfiguruj automatyczne generowanie zleceń w CMMS po przekroczeniu progu.
- Po sześćdziesięciu dniach porównaj liczbę alertów prawdziwych i fałszywych, koryguj progi tam, gdzie fałszywych alarmów jest zbyt wiele.
- Przeszkol techników z interpretacji alertów, zanim rozszerzysz program na kolejne maszyny.
Czego nauczyło mnie wdrażanie programów CBM
CBM nie działa od pierwszego dnia jak dobrze skalibrowany instrument. To proces iteracyjny: pierwsze progi generują zbyt wiele fałszywych alarmów, a zespół uczy się dopiero po kilku cyklach korekt, którym sygnałom naprawdę warto wierzyć. Jakość danych i dyscyplina operacyjna decydują o wyniku bardziej niż wybór czujnika.
— Mateusz
Synaptix Platform jako droga do przetestowania CBM we własnym zakładzie
Synaptix Platform integruje dane z czujników, modele predykcyjne i przepływy dokumentów w jednym środowisku, co skraca drogę od instalacji czujnika do działającego alertu w CMMS.
Moduł GridSense monitoruje aktywa w czasie rzeczywistym, a AutomateFlow automatyzuje przetwarzanie dokumentów serwisowych, w tym routing do SAP i Maximo. Platforma integruje się z protokołami MQTT, OPC-UA, Modbus i M-Bus, co ułatwia podłączenie istniejącego parku maszynowego bez wymiany infrastruktury.
| Moduł | Funkcja |
|---|---|
| GridSense | monitorowanie aktywów w czasie rzeczywistym |
| AutomateFlow | automatyzacja przetwarzania dokumentów i routing do SAP/Maximo |
Porada profesjonalisty: rozpocznij od pilota na wybranej grupie maszyn, żeby zweryfikować logikę alarmów przed decyzją o pełnym wdrożeniu.
Redukcja nieplanowanych przestojów możliwa dzięki technologii przewidywania awarii.
Szczegóły planów Pilot, Platform i Enterprise znajdziesz na stronie z ofertą Synaptix, gdzie można sprawdzić dostępność pilota dla własnego zakładu.
Źródła
Norma ISO 17359:2018 i badania NIST to punkt wyjścia do projektowania i oceny programu CBM. Producentom maszyn pomocne bywa też zestawienie SzopaLabs o kwalifikacji leadów.
- Comprehensive evaluations of condition-monitoring-based technologies in industrial applications (NIST)
Najczęściej zadawane pytania
Kim jest osoba odpowiedzialna za utrzymanie maszyn w dobrym stanie?
Za utrzymanie maszyn odpowiada zwykle zespół utrzymania ruchu kierowany przez managera lub inżyniera utrzymania, który planuje przeglądy, analizuje dane z czujników i decyduje o priorytetach naprawczych. W większych zakładach funkcję tę wspiera analityk danych interpretujący sygnały z systemów monitorowania stanu.
Jakie są rodzaje utrzymania ruchu?
Podstawowe strategie to konserwacja reaktywna, czyli praca do awarii, konserwacja zapobiegawcza wykonywana w ustalonych odstępach czasu, konserwacja oparta na stanie reagująca na mierzalne sygnały oraz konserwacja predykcyjna prognozująca moment awarii. Wybór strategii zależy od krytyczności danego aktywa i kosztu jego ewentualnego przestoju.
Czym jest utrzymanie ruchu?
Utrzymanie ruchu to zestaw działań zapewniających sprawność maszyn i instalacji produkcyjnych, obejmujący przeglądy, naprawy i monitorowanie stanu technicznego. Jego celem jest ograniczenie nieplanowanych przestojów i wydłużenie żywotności sprzętu.
Czy CBM wymaga dużej inwestycji w czujniki od samego początku?
Nie, program CBM najlepiej zaczynać od pilota na kilku krytycznych maszynach, a nie od jednoczesnego wyposażenia całego zakładu w czujniki. Taki pilot trwa zwykle około dwunastu tygodni i pozwala zweryfikować logikę progów przed decyzją o skalowaniu.